Лекція 15. Градієнт і геометрія напрямів зміни
Коротко про лекцію
Ви зберете часткові похідні у вектор градієнта та побачите його геометричний зміст. Лекція пояснює напрям найшвидшого зростання, напрям спадання та прогноз зміни функції вздовж заданого вектора.
Практичний сенс. Для функції багатьох змінних окремі часткові похідні показують локальну чутливість за координатами. Оптимізаційному алгоритму потрібен один узгоджений напрям руху в просторі всіх змінних. Градієнт збирає часткові похідні у вектор і дає такий напрям.
Постановка та базові поняття
1. Від часткових похідних до одного вектора
Для двох змінних ще можна тримати дві похідні окремо. Для десятків змінних такий підхід швидко стає незручним.
Векторна форма дозволяє застосовувати одну й ту саму операцію незалежно від кількості координат.
Нехай:
Тоді загальний градієнт:
Розмір градієнта збігається з розміром вектора рішення.
Ця відповідність критична в коді. Якщо порядок змінних у point і порядок компонентів у gradient різні, програма виконає векторну операцію, але рухатиметься в неправильному математичному напрямку.
Тому порядок компонентів є частиною моделі, а не технічною деталлю.
Розглянемо знайому функцію:
Її часткові похідні:
Замість двох окремих чисел зручно зберігати один вектор.
Градієнт позначають:
Символ \(\nabla\) читається «набла».
Для функції двох змінних:
1.1. Чому вектор похідних називають градієнтом
Після обчислення всіх часткових похідних їх можна зібрати у вектор. Цей вектор називають градієнтом і позначають \(\nabla f\). Він показує напрям найшвидшого локального зростання функції в евклідовій геометрії.
Для мінімізації потрібен протилежний рух. Якщо градієнт показує найшвидше зростання, напрям \(-\nabla f\) є природним напрямом локального спадання. Саме з цієї причини градієнт з’являється у методі градієнтного спуску.
Назва не повинна приховувати зміст: градієнт — це впорядкований набір локальних швидкостей зміни за координатами, який одночасно має геометричне значення напряму.
2. Градієнт наскрізної функції
Підставимо наші часткові похідні:
Цей вектор має стільки компонентів, скільки змінних у функції.
Перша компонента відповідає координаті \(x\).
Друга компонента відповідає координаті \(y\).
Порядок компонентів повинен збігатися з порядком змінних у векторі рішення.
3. Градієнт у конкретній точці
Компоненти градієнта мають локальний сенс.
Для першої координати:
Малий рух на \(\Delta x=0.01\) дає приблизну зміну:
Для другої координати:
Малий рух на \(\Delta y=0.01\) дає приблизно:
Якщо рухати обидві координати одночасно, окремі внески додаються в локальній лінійній моделі.
Для малого вектора зміни \(\Delta x\):
Ця формула пояснює, чому скалярний добуток градієнта на напрям є центральним об’єктом.
Розглянемо початкову точку:
Тоді:
Перша компонента від’ємна, тому збільшення \(x\) локально зменшує функцію.
Друга компонента додатна, тому збільшення \(y\) локально збільшує функцію.
Для мінімізації природний рух буде протилежним до цього вектора.
4. Геометричний образ
Градієнт має одночасно алгебраїчний і геометричний зміст.
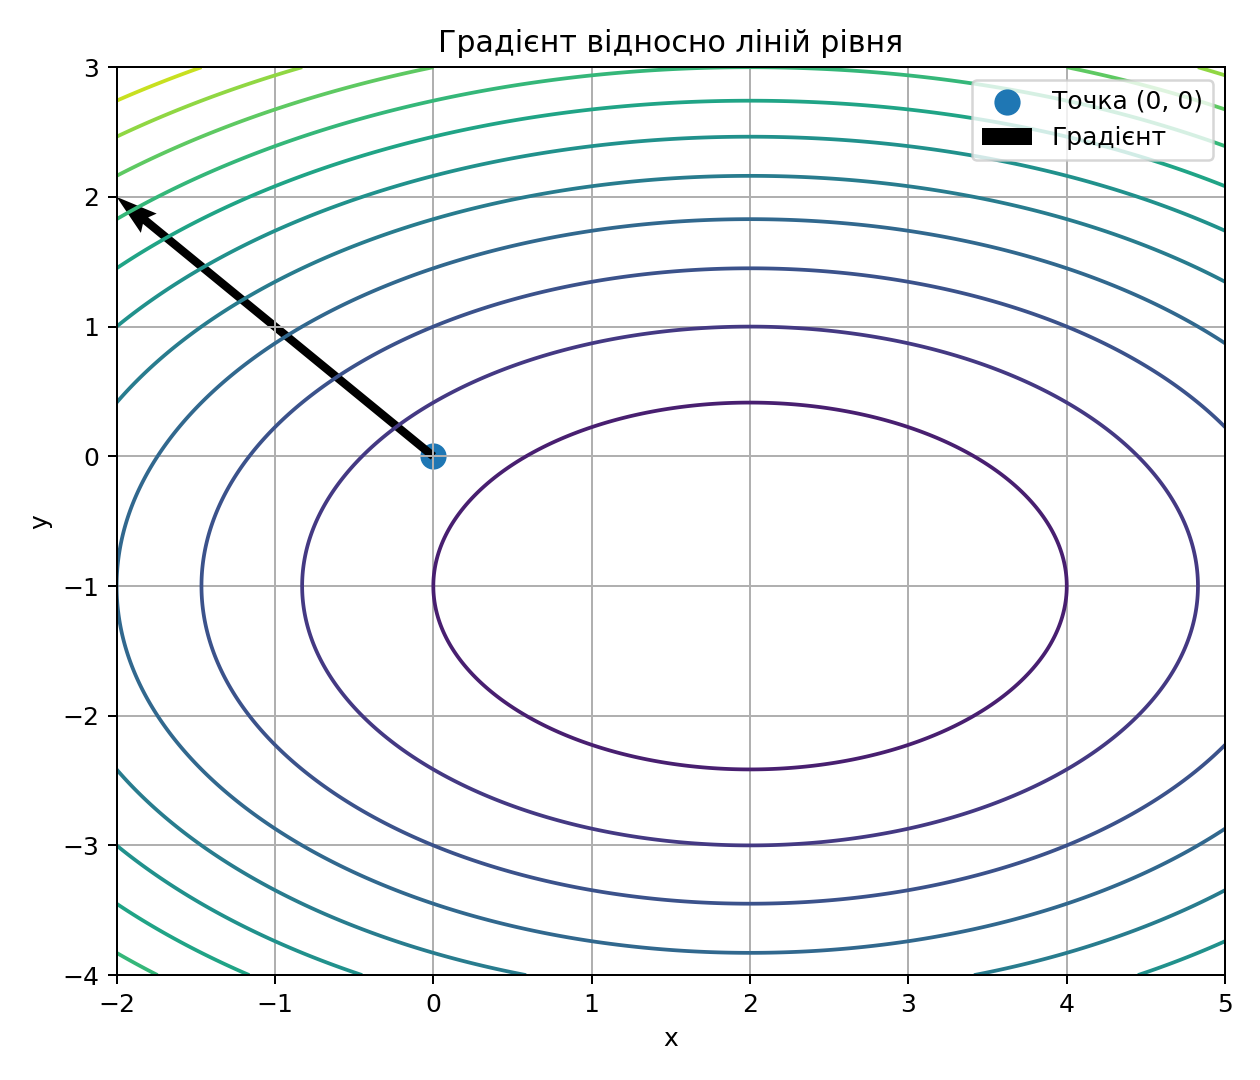
На контурному графіку градієнт перетинає лінію рівня під прямим кутом.
Він спрямований у бік найшвидшого локального зростання функції.
Протилежний вектор:
задає напрям найшвидшого локального спадання.
Математична логіка
5. Напрямна похідна
Розглянемо конкретний напрям:
Це рух тільки за першою координатою.
У точці \((0,0)\):
Отримали ту саму часткову похідну за \(x\).
Для напряму:
маємо \(D_uf=4\).
Отже, часткові похідні є спеціальними випадками напрямної похідної вздовж координатних осей.
Для довільного напрямку обидві компоненти працюють разом.
Якщо напрям не одиничний, числове значення змішує напрям і довжину вектора. Тому в означенні напрямної похідної зазвичай використовують одиничний \(u\).
Часткові похідні описують рух уздовж координатних осей.
Для довільного напрямку введемо одиничний вектор:
з умовою:
Напрямна похідна показує швидкість зміни функції вздовж \(u\).
Для диференційовної функції:
Це скалярний добуток градієнта на напрям.
6. Чому градієнт дає найбільше зростання
Нехай кут між градієнтом та одиничним напрямом \(u\) дорівнює \(\theta\).
Скалярний добуток можна записати:
Оскільки:
найбільше значення виникає при:
Тобто напрям \(u\) збігається з градієнтом.
Найменше значення виникає при:
Тоді напрям протилежний градієнту.
Саме тому антиградієнт дає найбільше локальне зменшення серед усіх одиничних напрямів.
Це твердження локальне. Воно описує дуже малий рух біля поточної точки й не гарантує, що великий крок у тому самому напрямі буде добрим.
Для двох векторів діє нерівність Коші — Буняковського:
Оскільки \(\|u\|_2=1\), маємо:
Найбільше значення досягається, коли \(u\) спрямований так само, як градієнт.
Тому градієнт задає напрям найбільшого локального зростання.
Антиградієнт задає напрям найбільшого локального спадання.
7. Норма градієнта
Евклідова норма вектора:
показує величину локальної зміни.
У точці \((0,0)\):
Тому:
Отримуємо:
Це велике ненульове значення, тому початкова точка далека від стаціонарності.
8. Градієнт у мінімізаторі
У точці:
маємо:
Тому:
Для внутрішнього гладкого мінімізатора без обмежень нульовий градієнт є необхідною умовою.
Як і в одновимірному випадку, нульовий градієнт ще не доводить мінімум для довільної функції.
9. Чому градієнт перпендикулярний до лінії рівня
Уявімо, що ми рухаємося по одній контурній лінії.
Значення \(f(x,y)\) залишається тим самим, тому локальна зміна функції вздовж дотичної дорівнює нулю.
Якщо \(t\) — дотичний вектор, маємо:
Вектори з нульовим скалярним добутком ортогональні.
Звідси виникає геометрична картина: градієнт дивиться поперек контурів, а не вздовж них.
Для нашої еліптичної функції градієнт у різних точках завжди спрямований від центру до зовнішніх рівнів.
Антиградієнт, відповідно, спрямований до внутрішніх рівнів і до мінімізатора.
Контурний графік дозволяє перевірити цей висновок візуально.
На лінії рівня значення функції не змінюється.
Отже, рух уздовж дотичної до лінії рівня має нульову напрямну похідну.
Нехай \(t\) — одиничний дотичний напрям.
Тоді:
Нульовий скалярний добуток означає перпендикулярність.
Тому градієнт є нормаллю до лінії рівня.
Це пояснює геометрію на контурному графіку.
Алгоритм і покроковий розбір
10. Від напрямку до кроку
Знання напряму ще не визначає нову точку.
Для руху потрібно вибрати довжину кроку \(\alpha\).
Базова формула:
Тут \(x_k\) — поточний вектор.
\(\nabla f(x_k)\) — градієнт у цій точці.
\(\alpha_k>0\) — довжина кроку.
Мінус перед градієнтом задає рух у напрямку локального спадання.
11. Один ручний крок
Початкова точка:
Градієнт:
Візьмемо:
Тоді:
Отримуємо:
12. Перевірка значення функції
У початковій точці:
У новій:
Після обчислення:
Тому:
Один крок у напрямку антиградієнта зменшив ціль.
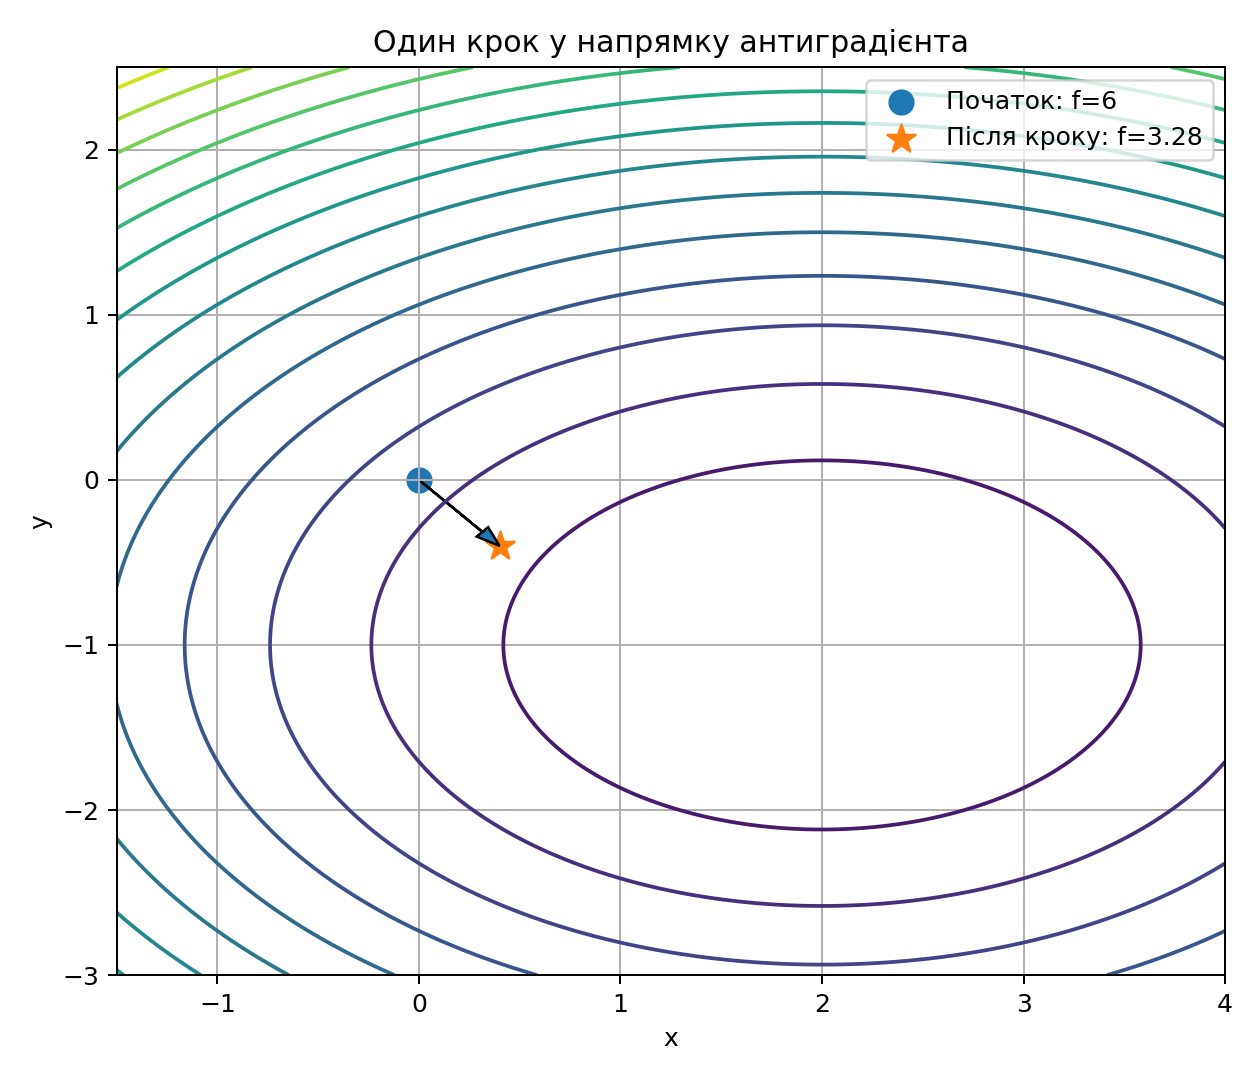
13. Чому крок 0.1 спрацював
Перевіримо ще кілька значень кроку з тієї самої точки.
Для \(\alpha=0.05\):
Значення функції зменшується, але рух коротший.
Для \(\alpha=0.1\) отримали:
і \(f=3.28\).
Якщо крок значно збільшити, можна пролетіти повз область мінімуму.
Тому антиградієнт відповідає на запитання «куди рухатися», а довжина кроку відповідає на запитання «наскільки далеко».
Ці дві частини алгоритму потрібно аналізувати окремо.
Наступні лекції покажуть градієнтний спуск і пошук довжини кроку як систематичний спосіб повторювати та контролювати такі кроки.
Формула антиградієнта дає локальний напрям.
Малий додатний крок зазвичай зменшує гладку функцію, якщо градієнт ненульовий.
Проте слово «малий» залежить від кривизни та масштабу задачі.
Надто великий крок може перескочити через долину.
Надто малий дає повільний прогрес.
Тому вибір \(\alpha\) стане окремою темою після введення градієнтний спуск.
14. Нормалізований напрям
Нормалізація корисна для геометричного пояснення, але вона змінює масштаб кроку.
Якщо використовувати:
то довжина геометричного кроку приблизно контролюється тільки \(\alpha\).
У стандартному градієнтний спуск маємо:
Тут довжина кроку залежить і від \(\alpha\), і від норми градієнта.
Далеко від стаціонарної точки градієнт може бути великим, тому крок також стає більшим.
Поблизу стаціонарної точки градієнт зменшується, і крок природно скорочується.
Ця властивість часто корисна, але іноді створює проблеми при поганому масштабуванні.
Іноді використовують тільки напрям градієнта:
Тоді \(u\) має одиничну довжину.
Антиградієнтний одиничний напрям:
відокремлює геометричний напрям від масштабу градієнта.
Проте стандартний градієнтний спуск зазвичай використовує сам градієнт, а масштаб контролює через \(\alpha\).
15. Алгоритм локальної діагностики
Для заданої точки корисний такий порядок.
- Обчислити всі часткові похідні.
- Зібрати градієнт у правильному порядку.
- Обчислити норму градієнта.
- Перевірити напрям \(-\nabla f\).
- Вибрати невеликий навчальний крок.
- Обчислити нову точку.
- Повторно обчислити функцію.
- Переконатися, що значення зменшилося.
- Якщо функція зросла, перевірити знак і довжину кроку.
Це ще не повний алгоритм оптимізації, але вже повна перевірка одного напрямного кроку.
Програмна реалізація та перевірка
16. Від математики до NumPy
Перш ніж множити масиви, потрібно перевірити форму даних.
Для двох змінних point.shape має бути (2,).
Результат gradient(point) також повинен мати форму (2,).
Якщо функція випадково повертає матрицю (2, 1), автоматичне узгодження розмірів масивів NumPy може створити неочікувану двовимірну операцію.
Тому в навчальному коді корисно перевіряти:
# Перевіряємо розмірності масивів до обчислень, щоб координати та похідні відповідали одне одному.
assert point.shape == (2,)
assert current_gradient.shape == point.shape
Ці перевірки не доводять математичну правильність градієнта, але захищають від помилки форми.
Після цього математичну правильність перевіряють через чисельні похідні та нев’язка.
| Математика | Python | Зміст |
|---|---|---|
| \(x_k\) | point |
поточний вектор |
| \(\nabla f(x_k)\) | gradient |
градієнт |
| \(\alpha\) | step_size |
довжина кроку |
| \(x_{k+1}\) | next_point |
нова точка |
| \(\|\nabla f\|_2\) | gradient_norm |
величина градієнта |
Код:
# Імпортуємо NumPy для обчислень, розв’язання моделі та її перевірки.
import numpy as np


# Описуємо цільову функцію тією самою формулою, що й у математичній постановці.
def objective(point):
    x = point[0]
    y = point[1]

    # Повертаємо обчислене значення, яке використає наступний крок алгоритму або перевірки.
    return (
        (x - 2.0) ** 2
        + 2.0 * (y + 1.0) ** 2
    )


# Описуємо градієнт у фіксованому порядку координат, щоб код відповідав математичному вектору.
def gradient(point):
    x = point[0]
    y = point[1]

    # Повертаємо обчислене значення, яке використає наступний крок алгоритму або перевірки.
    return np.array([
        2.0 * (x - 2.0),
        4.0 * (y + 1.0),
    ])

# Мінімальна перевірка робить приклад самодостатнім і одразу показує напрям антиградієнта.
probe_point = np.array([
    0.0,
    0.0,
])
print("f(0, 0):", objective(probe_point))
print("Градієнт у (0, 0):", gradient(probe_point))
Функція gradient повертає вектор того самого розміру, що й point.
17. Програмний крок антиградієнта
# Задаємо конкретну точку, план або множники, для яких далі виконаємо математичну перевірку.
point = np.array([
    0.0,
    0.0,
])

# Задаємо параметр алгоритму, вплив якого далі перевіримо на результаті.
step_size = 0.1

# Обчислюємо градієнтну характеристику або нову точку.
current_gradient = gradient(point)

# Обчислюємо градієнтну характеристику або нову точку.
next_point = (
    point
    - step_size * current_gradient
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print("Градієнт:", current_gradient)
print("Нова точка:", next_point)
print("Стара ціль:", objective(point))
print("Нова ціль:", objective(next_point))
Очікувано:
Градієнт: [-4.  4.]
Нова точка: [ 0.4 -0.4]
Стара ціль: 6.0
Нова ціль: 3.28
18. Перевірка норми
# Обчислюємо норму діагностичного вектора; мале значення використовуємо як критерій перевірки.
gradient_norm = np.linalg.norm(
    current_gradient
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print(gradient_norm)
Очікуване значення:
5.656854...
np.linalg.norm обчислює довжину вектора.
Для внутрішньої стаціонарної точки очікується мала норма градієнта.
19. Чисельна перевірка градієнта
Для реалізації перевірки можна послідовно змінювати кожну координату.
# Виносимо окрему математичну операцію в допоміжну функцію, щоб її було легко перевірити.
def numerical_gradient(
    function,
    point,
    step=1e-5,
):
    result = np.zeros_like(
        point,
        dtype=float,
    )

    # Перебираємо вибрані тестові значення, щоб порівняти поведінку методу на кількох випадках.
    for index in range(point.size):
        plus = point.copy()
        minus = point.copy()

        # Обчислюємо градієнтну характеристику або нову точку.
        plus[index] += step
        minus[index] -= step

        # Обчислюємо градієнтну характеристику або нову точку.
        result[index] = (
            function(plus)
            - function(minus)
        ) / (2.0 * step)

    # Повертаємо обчислене значення, яке використає наступний крок алгоритму або перевірки.
    return result
Для точки \((0,0)\) очікуємо приблизно:
[-4. 4.]
Після цього можна порівняти аналітичний та чисельний вектори нормою різниці.
Цей тест добре знаходить помилки знака, пропущені коефіцієнти та переплутаний порядок координат.
Кожну компоненту можна перевірити центральною різницею.
Для координати \(i\):
Тут \(e_i\) — одиничний координатний вектор.
Для двох змінних потрібно виконати дві незалежні перевірки.
Це дозволяє знайти помилки в аналітичній формулі градієнта.
20. Нев’язка перевірки градієнта
Для конкретного прикладу перевіримо числовий масштаб нев’язка.
Якщо аналітичний градієнт:
а чисельний:
то різниця дуже мала.
Нев’язка:
буде близьким до машинної похибки.
У реальній задачі не потрібно вимагати абсолютного нуля.
Важливо, щоб нев’язка був малим відносно масштабу компонентів градієнта.
Якщо одна компонента має величину \(10^6\), а нев’язка дорівнює \(10^{-8}\), узгодженість дуже висока.
Якщо сам градієнт має масштаб \(10^{-10}\), той самий абсолютний нев’язка вже потребує іншої інтерпретації.
Нехай:
— аналітичний градієнт, а:
— чисельний.
Тоді можна обчислити:
Малий нев’язка підтверджує узгодженість двох реалізацій.
Ця перевірка особливо важлива перед використанням власного градієнта у чисельний розв’язувач-і.
Інтерпретація, межі та підсумок
21. Типові помилки
Типова помилка. Для мінімізації рухаються у напрямку \(+\nabla f\). Цей напрям локально збільшує функцію.
Друга помилка — переставити компоненти градієнта.
Третя — використовувати норму градієнта як доказ глобального оптимуму.
Четверта — зробити великий крок і звинуватити формулу градієнта в зростанні функції.
П’ята — порівнювати компоненти без урахування одиниць і масштабу змінних.
22. Що означає мала норма градієнта
При чисельній оптимізації точного нуля майже ніколи не вимагають.
Замість цього використовують:
Наприклад:
означає, що локальний нахил став дуже малим.
Важливо розуміти масштаб. Для функції, значення якої природно мають величину \(10^{12}\), числовий допуск \(10^{-6}\) може бути надмірним.
Для іншої задачі з дуже малими величинами той самий поріг може бути недостатньо суворим.
Тому критерій зупинки потрібно пов’язувати з масштабом задачі та іншими нев’язка.
Мала норма означає, що локальна лінійна зміна невелика в усіх координатних напрямах.
Це корисний критерій стаціонарності.
Проте пласка область, сідлова точка або локальний максимум також можуть мати малий градієнт.
Тому результат потрібно читати разом із поведінкою функції та додатковими умовами.
23. Градієнт і масштабування
Припустімо, що одна змінна вимірюється в кілометрах, а інша в міліметрах.
Одна одиниця першої координати та одна одиниця другої мають зовсім різний фізичний зміст.
Тому компоненти градієнта можуть відрізнятися на багато порядків.
Траєкторія алгоритму тоді може рухатися зигзагами або вимагати дуже малого кроку.
Один із практичних способів — перейти до масштабованих змінних приблизно однакового порядку.
Сам градієнт залежить від вибраних координат, тому масштабування змінює чисельну геометрію задачі.
Це не змінює предметну мету, якщо перетворення виконано коректно.
Якщо одна змінна має масштаб тисячі, а інша — тисячні частки, компоненти градієнта можуть сильно відрізнятися.
Тоді траєкторія градієнтний спуск може бути незручною.
Масштабування змінних змінює геометрію чисельної задачі.
Пізніше курс повернеться до цього питання під час аналізу збіжності та обумовленість.
24. Місце градієнта в оптимізації
Градієнт також використовується як діагностичний об’єкт під час налагодження моделі.
Якщо зміна координати очевидно повинна збільшувати витрати, а відповідна компонента градієнта має протилежний знак, варто перевірити формулу.
У складній програмі перевірка градієнта може виконуватися на кількох випадкових контрольних точках перед запуском довгого чисельного розв’язувача.
Такий тест дешевший за пошук причини після сотень невдалих ітерацій.
У навчальних роботах достатньо однієї-двох точок і центральної різниці.
Важливо зберігати розділення ролей: аналітичний градієнт використовується алгоритмом, а чисельний градієнт служить незалежним тестом.
Градієнт є основним об’єктом для багатьох алгоритмів.
Градієнтний спуск використовує антиградієнт безпосередньо.
метод Ньютона поєднує градієнт із матрицею других похідних.
BFGS використовує зміни градієнта для побудови наближення кривизни.
KKT-умови містять градієнти цілі та обмежень.
Тому правильне обчислення й перевірка градієнта є базовою технічною навичкою.
24.1. Градієнт як локальна модель функції
Для малого вектора кроку \(s\) діє наближення:
Якщо вибрати:
то:
Для \(\alpha>0\) і ненульового градієнта цей вираз від’ємний.
Тому локальна лінійна модель прогнозує зменшення функції.
Це коротке математичне пояснення антиградієнтного кроку.
Проте наближення працює локально. При великому \(\alpha\) члени вищого порядку можуть змінити фактичний результат.
Саме тому після кожного навчального кроку ми повторно обчислюємо \(f(x_{k+1})\).
24.2. Перевірка напрямку перед запуском алгоритму
Перед довгою оптимізацією можна виконати простий напрямal перевірка.
Виберіть точку \(x\) і малий крок \(\delta\).
Обчисліть:
та порівняйте з \(f(x)\).
За достатньо малого \(\delta\) для коректного ненульового градієнта очікується зменшення функції.
Якщо функція стабільно зростає, потрібно перевірити знак градієнта, порядок компонентів і формулу цілі.
Такий тест не замінює повний перевірка градієнта, але швидко виявляє грубі помилки.
24.3. Конкретна напрямна похідна
Візьмемо одиничний напрям:
У точці \((0,0)\) градієнт дорівнює \((-4,4)^T\).
Тому:
Отримуємо від’ємне значення:
Це означає, що обраний напрям локально зменшує функцію.
Він збігається з напрямом антиградієнта після нормалізації.
Тому числовий приклад узгоджується з геометричним твердженням про найшвидше локальне спадання.
24.4. Мінімальний звіт про один градієнтний крок
У студентській роботі варто показати:
- початкову точку;
- градієнт;
- норму градієнта;
- значення \(\alpha\);
- нову точку;
- старе та нове значення функції;
- висновок про зменшення.
Такий формат дає змогу перевірити і напрям, і арифметику, і предметний результат.
24.5. Підсумкова перевірка градієнта
Перед використанням градієнта в ітераційний чисельний розв’язувач корисно перевірити три умови.
Перша: форма вектора градієнта збігається з формою точки.
Друга: чисельний перевірка градієнта дає малий нев’язка.
Третя: малий антиградієнтний крок зменшує функцію у контрольній точці.
Разом ці тести перевіряють структуру, арифметику та напрям.
24.6. Практичний висновок про напрям і крок
У градієнтному методі легко змішати дві різні задачі.
Градієнт визначає локальний напрям, а \(\alpha\) визначає довжину руху.
Правильний напрям із невдалим кроком може дати поганий результат.
Тому після кожного навчального кроку потрібно порівнювати старе й нове значення цілі.
Це просте правило формує звичку перевіряти алгоритм чисельно, а не довіряти формулі без контролю.
24.7. Контрольне правило
Градієнт потрібно перевіряти як математичний вектор: правильний порядок компонентів, правильний знак, правильний масштаб і малий чисельний нев’язка.
24.8. Остаточний критерій якості
Коректний градієнтний крок повинен бути зрозумілим математично й відтворюваним чисельно. Студент має вміти пояснити напрям, обчислити нову точку, порівняти значення функції та перевірити градієнт незалежним способом.
Контроль перед завершенням
Перед переходом до наступної теми перевірте, чи можете власними словами пояснити математичний зміст методу, виконати один ручний розрахунок і назвати критерій незалежної перевірки результату.
Перед фінальним висновком перевірте, чи можете відтворити антиградієнтний крок вручну та пояснити, чому зменшення функції потрібно контролювати після кожної ітерації.
Інтерактивна самоперевірка лекції
Пройдіть 10 коротких питань. Після кожної відповіді ви побачите пояснення, а за потреби — підказку й повний розбір.
25. Підсумок
Градієнт об’єднує всі перші часткові похідні у вектор того самого розміру й порядку, що й вектор змінних. Скалярний добуток \(\nabla f(x)^Td\) з одиничним напрямом \(d\) дає напрямну похідну, тому градієнт описує найшвидше локальне зростання, а антиградієнт — найшвидше локальне спадання. Норма \(\|\nabla f(x)\|_2\) вимірює величину цього локального нахилу.
Для функції \((x-2)^2+2(y+1)^2\) у точці \((0,0)\) градієнт дорівнює \((-4,4)^T\). Крок \(x_{\text{new}}=x-\alpha\nabla f(x)\) з \(\alpha=0.1\) переводить точку в \((0.4,-0.4)\) і зменшує ціль з 6 до 3.28. Цей приклад показує дві окремі ролі: градієнт задає напрям, а коефіцієнт \(\alpha\) задає довжину руху.
Після кроку потрібно повторно обчислити ціль і перевірити, чи відбулося очікуване зменшення. Аналітичний градієнт також варто незалежно зіставити зі скінченно-різницевою оцінкою. Ці перевірки утворюють основу градієнтного спуску, де той самий крок повторюється багато разів із новим градієнтом у кожній точці.