Лекція 27. Багатокритеріальна оптимізація та Парето-компроміси; Чисельна надійність та аудит оптимізаційного розв’язку
Коротко про лекцію
Тут одна ціль замінюється кількома критеріями, які можуть конфліктувати. Ви навчитеся знаходити доміновані рішення, будувати множину Парето та обґрунтовано вибирати компроміс через ваги або інший прозорий критерій.
Практичний сенс. У прикладній задачі часто є кілька цілей: зменшити витрати, скоротити час, знизити ризик, підвищити якість або надійність. Такі цілі можуть конфліктувати. Багатокритеріальна оптимізація допомагає відсіяти явно гірші рішення, побудувати множину раціональних компромісів і прозоро пояснити, чому фінальний вибір залежить від пріоритетів.
Постановка та базові поняття
1. Коли одного критерію недостатньо
У звичайній однокритеріальній задачі ми маємо одне число, яке потрібно мінімізувати або максимізувати. Після цього два допустимі рішення легко порівняти: менше значення краще для мінімізації, більше — для максимізації. Такий порядок дає зрозумілий математичний орієнтир.
У реальній системі часто одночасно важливі кілька показників. Логістичний план оцінюють за вартістю та часом доставки. Інженерну конструкцію — за масою, міцністю та ціною. Виробничий план — за прибутком, ризиком і використанням дефіцитного ресурсу. Один варіант може виграти за першим показником і програти за другим.
Через це слово «краще» потребує уточнення. Якщо план A дешевший, а план B швидший, математична модель ще не має підстав автоматично оголосити один із них переможцем. Спочатку треба формально описати окремі критерії, їхні напрями та правило порівняння.
Нехай допустиме рішення позначено через \(x\). Для двох критеріїв записуємо:
Вектор \(F(x)\) називають вектором критеріїв. Кожна його компонента має власний предметний зміст, одиниці вимірювання та напрям покращення.
2. Вектор критеріїв, напрями та одиниці
У цій лекції основна домовленість така: усі критерії приводимо до мінімізації. Тоді менше числове значення означає краще значення конкретного критерію. Така домовленість робить правило домінування однозначним.
Якщо початковий показник треба максимізувати, його можна перетворити. Наприклад, максимізацію прибутку \(p(x)\) можна записати як мінімізацію:
У звіті предметне значення прибутку варто показувати в природному знаку. Перетворення потрібне для внутрішньої математичної логіки порівняння.
Одиниці критеріїв також мають значення. Вартість може вимірюватися в гривнях, час — у годинах, ризик — у безрозмірній шкалі. Ці величини можна зберігати окремо без проблем. Питання масштабу стає критичним тоді, коли критерії об’єднують в одну скалярну ціль.
Для \(k\) критеріїв загальний запис має вигляд:
Вектор критеріїв зберігає більше інформації, ніж одна зважена сума. Тому на початку багатокритеріального аналізу корисно працювати саме з окремими компонентами.
3. Домінування на дискретному прикладі
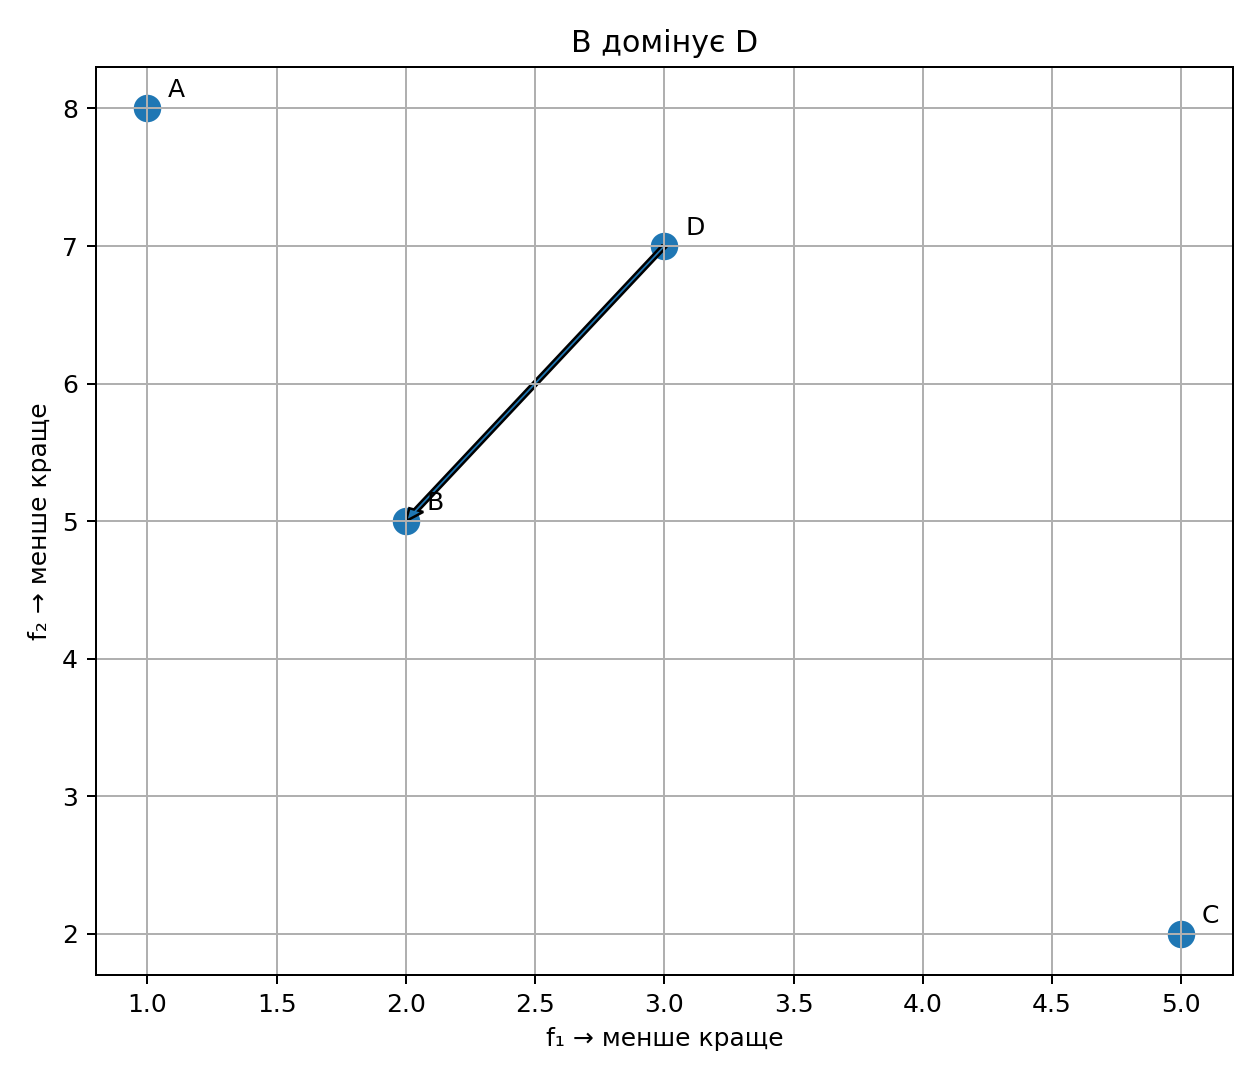
Розглянемо чотири допустимі варіанти. Обидва критерії мінімізуються.
| Варіант | \(f_1\) | \(f_2\) |
|---|---|---|
| A | 1 | 8 |
| B | 2 | 5 |
| C | 5 | 2 |
| D | 3 | 7 |
Порівняймо B та D. Для першого критерію:
Для другого:
Варіант B кращий за D за обома критеріями. Тому D можна вилучити з подальшого аналізу компромісів.
Формально для задачі мінімізації рішення \(x^{(A)}\) домінує \(x^{(B)}\), якщо виконуються дві умови. Перша:
для кожного критерію \(i\). Друга: хоча б для одного критерію \(j\) виконується строга нерівність:
Перша умова означає, що A ніде не гірше. Друга гарантує реальне покращення хоча б однієї компоненти.
Тепер порівняймо B та C. Для першого критерію B кращий:
Для другого критерію C кращий:
Ці рішення непорівнянні за домінуванням. Кожне має власну перевагу, тому математична модель зберігає обидва як можливі компроміси.
Математична логіка
4. Парето-оптимальність і фронт Парето
Допустиме рішення називають Парето-оптимальним, якщо серед допустимих рішень немає іншого рішення, яке його домінує. Для скінченного набору це означає просту перевірку: для кожного кандидата треба пошукати кращий або рівний за всіма критеріями варіант із хоча б одним строгим покращенням.
У дискретному прикладі D домінується B, тому D не входить до Парето-множини. Варіанти A, B і C попарно мають різні компроміси. Вони утворюють недомінований набір для цієї таблиці.
Тут важливо розділити два простори. Парето-множина містить самі рішення \(x\) у просторі змінних. Фронт Парето містить відповідні вектори критеріїв \(F(x)\) у просторі критеріїв.
Схематично:
Одне рішення переходить у точку простору критеріїв. Два різні рішення можуть мати однаковий вектор критеріїв, тому фронт Парето не завжди зберігає всю інформацію про альтернативи.
Парето-оптимальність ще не визначає остаточний вибір. Вона відсіює рішення, для яких існує однозначно краща альтернатива. Після цього залишається множина компромісів, між якими потрібне окреме правило переваг.
Геометрично для двох критеріїв простір критеріїв можна намалювати на площині. Оскільки обидва критерії мінімізуються, бажаний напрям лежить до нижнього лівого кута. Точка, яка розташована правіше й вище іншої, програє за обома показниками та є очевидним кандидатом на вилучення. Недоміновані точки формують межу, за якою подальший рух до нижнього лівого кута вже потребує компромісу.
Такий рисунок особливо корисний перед скаляризацією. Він дозволяє побачити, чи одна точка справді домінує іншу, чи два рішення є непорівнянними. Для трьох критеріїв аналогічна логіка працює у тривимірному просторі, але візуальне читання стає складнішим. Тому алгоритмічна перевірка домінування залишається основним інструментом для більшої кількості критеріїв.
5. Наскрізний неперервний приклад
Розглянемо одну змінну:
і два критерії мінімізації:
Перший критерій має мінімум у точці \(x=0\). Другий має мінімум у точці \(x=4\). Спільного мінімізатора немає.
У кількох точках отримуємо:
| \(x\) | \(f_1(x)\) | \(f_2(x)\) |
|---|---|---|
| 0 | 0 | 16 |
| 1 | 1 | 9 |
| 2 | 4 | 4 |
| 3 | 9 | 1 |
| 4 | 16 | 0 |
Коли \(x\) зростає від 0 до 4, перший критерій монотонно погіршується, а другий монотонно покращується. Через це жодна точка інтервалу не домінує іншу.
Для будь-яких \(x_a<x_b\) маємо:
і водночас:
Отже, весь інтервал \([0,4]\) є Парето-множиною цієї навчальної задачі. Відповідний фронт задається параметрично:
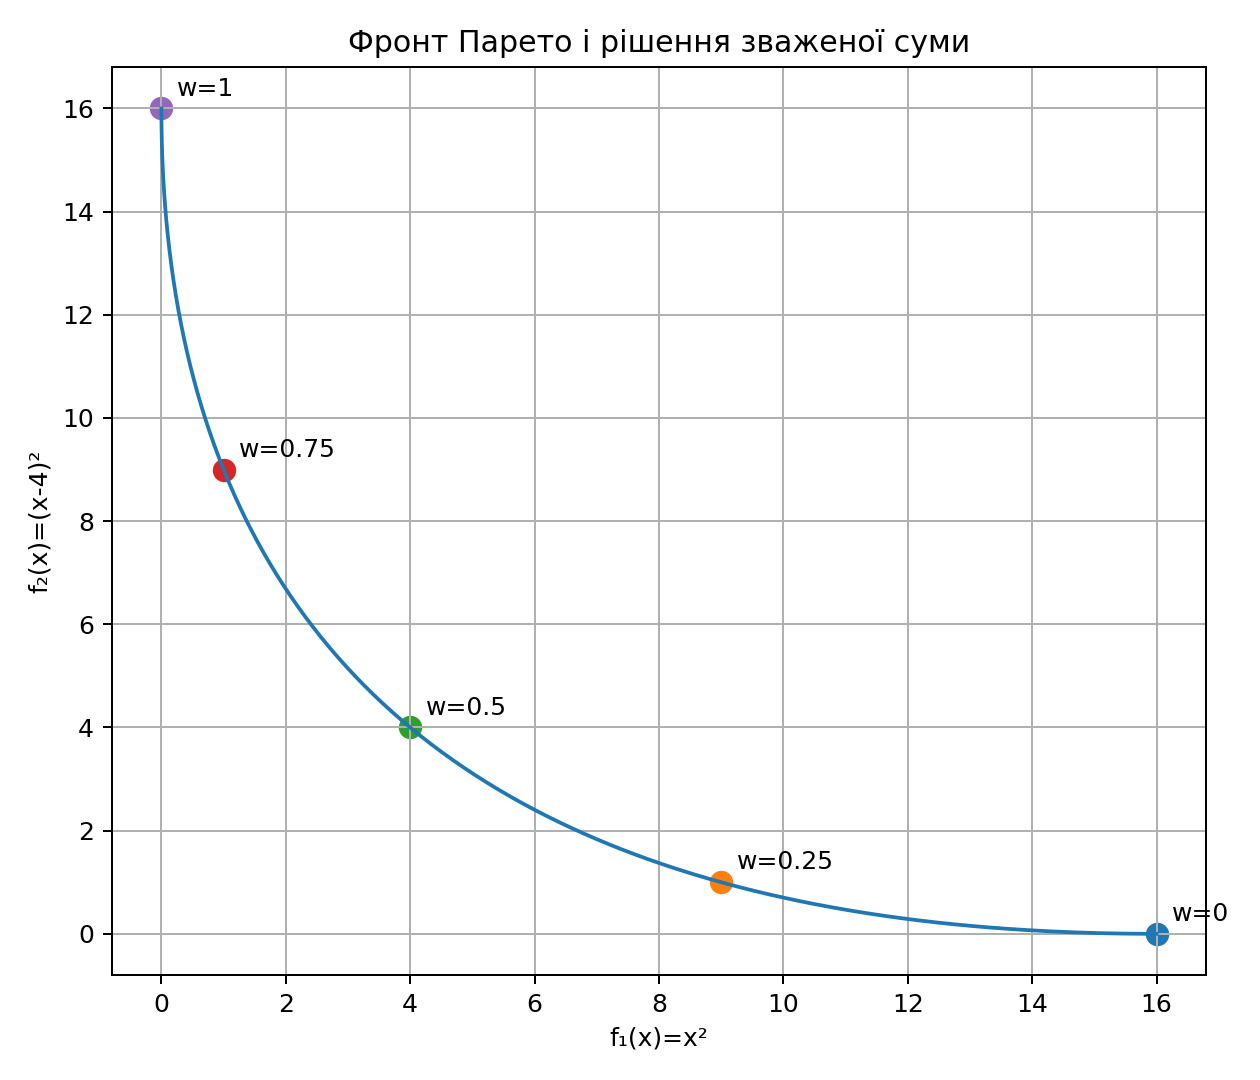
Цей приклад корисний тим, що Парето-оптимальність тут можна підтвердити аналітично, без перебору сітки. Монотонність двох критеріїв дає повний доказ для всього інтервалу.
Цей приклад також показує різницю між рішенням і його образом у просторі критеріїв. Значення \(x\) відповідає конкретному рішенню, а пара \((f_1(x),f_2(x))\) показує наслідки цього рішення за двома показниками. У прикладному звіті потрібно зберігати обидва представлення, бо сам фронт показує компроміс, але не завжди містить достатньо інформації для реалізації плану.
Для двох критеріїв фронт легко показати на площині. Уздовж цієї кривої корисно позначити кілька характерних точок: два однокритеріальні оптимуми та один або два внутрішні компроміси. Такий рисунок допомагає студенту побачити Парето-аналіз як структуру можливих обмінів між критеріями та множину раціональних компромісів.
6. Зважена сума та явний компроміс
Один із найпростіших способів вибрати конкретну Парето-точку — об’єднати критерії в одну ціль. Для двох критеріїв:
де:
Параметр \(w\) задає числовий пріоритет першого критерію після того, як масштаби критеріїв уже узгоджені.
Для наскрізної задачі:
Обчислимо похідну:
Розкриваємо дужки:
Стаціонарність дає:
Тому:
Формула дозволяє побачити весь рух компромісу. При \(w=0\) маємо \(x^*=4\), тобто оптимізується другий критерій. При \(w=1\) маємо \(x^*=0\), тобто пріоритет отримує перший критерій. Для \(w=0.5\):
і:
Симетрія цього результату пов’язана з однаковим масштабом і симетричною формою двох критеріїв.
7. Нормування та зміст ваг
Нехай перший критерій вимірюється десятками, а другий — сотнями тисяч. Тоді однакові ваги \(0.5\) і \(0.5\) не створюють однаковий вплив на скалярну ціль. Більший числовий масштаб може переважити зміст ваг.
Один із способів — перейти до безрозмірних критеріїв. Наприклад:
Після цього зважена сума будується вже для \(\widetilde f_i\). Значення \(f_i^{\min}\) і \(f_i^{\max}\) треба отримати з прозорого правила: відомих предметних меж, окремих однокритеріальних оптимумів або обґрунтованого діапазону.
Нормування змінює числовий зміст ваг. Тому фінальний звіт повинен зберігати три речі: початкові критерії в природних одиницях, правило нормування та ваги після нормування.
Вага \(w=0.7\) сама по собі ще мало що пояснює. Її інтерпретація залежить від шкал, у яких об’єднані критерії. Тому багатокритеріальна модель повинна робити масштабування явним.
Корисно спочатку розв’язати кілька однокритеріальних задач. Мінімум кожного критерію окремо показує його найкраще досяжне значення, а значення інших критеріїв у цій точці демонструють ціну крайніх пріоритетів. Так з’являються природні опорні точки для пояснення масштабу та конфлікту.
Із цих однокритеріальних мінімумів можна побудувати ідеальну точку в просторі критеріїв:
Для наскрізного прикладу маємо:
Проте жодне \(x\in[0,4]\) не дає одночасно \(f_1=0\) і \(f_2=0\). Ідеальна точка тут є орієнтиром, а не допустимим результатом. Вона показує, у якому напрямі хотілося б рухати фронт, і допомагає пояснити відстань реальних компромісів від недосяжного еталона.
У прикладному звіті варто уникати фрази «вага 0.7 означає 70% важливості» без додаткового обґрунтування. Математично вага визначає коефіцієнт у скалярній цілі. Предметний зміст виникає після фіксації нормування, одиниць і способу отримання самої ваги. Це розділення захищає від надто сильних інтерпретацій одного технічного параметра.
8. Метод епсилон-обмеження та межі зваженої суми
Інший спосіб побудувати компроміс — залишити один критерій ціллю, а інший перенести в обмеження:
за умови:
Параметр \(\varepsilon\) має зрозумілий предметний зміст, якщо другий критерій має природну допустиму межу. Наприклад: мінімізуємо вартість, а час доставки повинен бути не більшим за 8 годин.
Змінюючи \(\varepsilon\), можна отримувати різні Парето-рішення. Такий підхід зручний, коли фахівцю простіше сформулювати межу, ніж абстрактну вагу.
Метод зваженої суми має геометричне обмеження. Для опуклої множини досяжних векторів критеріїв він добре знаходить підтримувані точки фронту. На неопуклому фронті можуть існувати Парето-точки, які не є оптимальними для жодної додатної зваженої суми.
Тому серія ваг не гарантує повного відновлення довільного Парето-фронту. Для складних задач використовують епсилон-обмеження, інші скаляризації або спеціалізовані багатокритеріальні алгоритми.
Покажемо епсилон-обмеження на наскрізному прикладі. Нехай другий критерій повинен задовольняти:
Тоді:
На відрізку \([0,4]\) це означає:
Тепер мінімізуємо \(f_1(x)=x^2\) на новій допустимій області. Найменше значення отримуємо при \(x=2\). Таким чином, поріг \(\varepsilon=4\) приводить до тієї самої компромісної точки \((4,4)\) у просторі критеріїв, яку для симетричного прикладу дала вага \(w=0.5\).
Цей збіг пов’язаний зі структурою конкретної задачі. В іншій моделі вага та епсилон-поріг можуть приводити до різних частин фронту. Тому параметри скаляризації слід трактувати як різні способи формалізувати пріоритети.
Алгоритм і покроковий розбір
9. Фільтрація недомінованих рішень
Для скінченного набору алгоритм прямо повторює означення домінування.
Спочатку беремо кандидат \(i\). Далі перебираємо всі інші кандидати \(j\). Якщо знайдено хоча б один \(j\), який домінує \(i\), кандидат \(i\) вилучається. Якщо домінуючого рішення немає, кандидат залишається в Парето-наборі.
Для \(N\) кандидатів і \(m\) критеріїв прямий попарний перебір потребує приблизно:
операцій порівняння. Для десятків або сотень точок такий алгоритм достатньо прозорий і швидкий. Він також корисний як еталонний перевіряльник для складнішої реалізації.
Покроково для таблиці A, B, C, D:
- A порівнюємо з B, C, D. Домінуючої точки немає.
- B порівнюємо з A, C, D. Домінуючої точки немає.
- C порівнюємо з A, B, D. Домінуючої точки немає.
- D порівнюємо з A, B, C. B домінує D, тому D вилучаємо.
Після фільтрації залишаються A, B і C.
10. Допуск, рівність і дублікати
Для точних цілих чисел правило домінування реалізується буквально. Для чисел із рухомою комою маленька різниця може бути наслідком обчислювальної похибки.
Наприклад, значення:
і:
можуть бути предметно еквівалентними в задачі, де точність даних значно грубіша. Тому практичний перевіряльник може використовувати допуск \(\tau\).
Ідея «не гірше» тоді записується приблизно як:
Строге покращення теж треба визначити узгоджено. Наприклад:
Значення \(\tau\) входить до контракту перевірки. Його треба зберігати в коді та звіті разом із правилом порівняння.
Практичний варіант перевірки з допуском може використовувати дві логічні умови. Перша дозволяє малі числові відхилення під час перевірки «не гірше». Друга вимагає покращення, яке перевищує допуск. Це зменшує ризик випадково оголосити домінування через шум останніх десяткових знаків.
Значення допуску треба пов’язати з масштабом критеріїв. Якщо один критерій має порядок \(10^{-3}\), а інший \(10^6\), один абсолютний допуск для обох компонент може бути невдалим. У таких випадках корисно використовувати масштабовані або відносні правила порівняння.
Практична функція домінування з абсолютним допуском може виглядати так:
def dominates_with_tolerance(
    first,
    second,
    tolerance,
):
    # "Не гірше" дозволяє мале перевищення в межах tolerance.
    no_worse = all(
        a <= b + tolerance
        for a, b in zip(first, second)
    )

    # Строге покращення повинно перевищувати числовий шум.
    strictly_better = any(
        a < b - tolerance
        for a, b in zip(first, second)
    )

    # Обидві умови відповідають означенню домінування з допуском.
    return (
        no_worse
        and strictly_better
    )
Такий код підходить лише тоді, коли один абсолютний tolerance має сенс для всіх компонент. За дуже різних масштабів
критеріїв краще спочатку нормувати їх або використовувати окремі допуски.
Окремо треба вирішити питання дублікатів. Якщо два різні рішення мають однаковий вектор критеріїв, у просторі критеріїв це одна точка. У просторі рішень це дві різні альтернативи. Залежно від задачі їх можна зберігати обидві або дедуплікувати лише для візуалізації фронту.
11. Побудова набору компромісів
Одна вага у зваженій сумі дає один компроміс. Щоб побачити, як змінюється рішення, можна використати сітку ваг:
Для нашої формули:
отримуємо:
| \(w\) | \(x^*\) | \(f_1(x^*)\) | \(f_2(x^*)\) |
|---|---|---|---|
| 0 | 4 | 16 | 0 |
| 0.25 | 3 | 9 | 1 |
| 0.5 | 2 | 4 | 4 |
| 0.75 | 1 | 1 | 9 |
| 1 | 0 | 0 | 16 |
Таблиця показує ціну компромісу. Рух у бік покращення першого критерію поступово погіршує другий.
У загальній задачі різні ваги можуть давати однаковий розв’язок. Тоді результат варто дедуплікувати з допуском, але зберегти інформацію про ваги, які привели до цієї точки.
Для епсилон-обмеження аналогічно будують сітку порогів \(\varepsilon\). Кожен поріг створює окрему оптимізаційну задачу, а результати потім перевіряють на домінування.
Програмна реалізація та перевірка
12. Перевірка домінування у Python
Спочатку зафіксуємо відповідність між математикою та кодом.
| Математика | Python | Зміст |
|---|---|---|
| \(F(x)\) | point |
вектор критеріїв одного рішення |
| \(f_j\) | компонент point[j] |
один критерій |
| домінування | dominates(first, second) |
логічна перевірка двох векторів |
| Парето-набір | points[pareto_mask] |
недоміновані вектори |
| \(w\) | weight |
вага першого критерію |
| \(x^*(w)\) | weighted_solution(weight) |
компроміс для заданої ваги |
Функція домінування для точних чисел:
import numpy as np


# first і second мають однаковий порядок критеріїв [f1, f2, ...].
# У цій лекції всі критерії приведені до мінімізації.
def dominates(first, second):
    # Перша умова: first ніде не має більшого значення критерію.
    no_worse = np.all(
        first <= second
    )

    # Друга умова: хоча б один критерій у first строго менший.
    strictly_better = np.any(
        first < second
    )

    # Домінування виконується лише за одночасного виконання двох умов.
    return bool(
        no_worse
        and strictly_better
    )
Перевіримо B та D:
# Вектори записані в порядку [f1, f2].
B = np.array([2.0, 5.0])
D = np.array([3.0, 7.0])

# B має менші значення за обома критеріями, тому очікуємо True.
print(
    dominates(B, D)
)
Очікуваний результат:
True
Тепер відфільтруємо всю таблицю:
# Рядки відповідають A, B, C, D.
points = np.array([
    [1.0, 8.0],
    [2.0, 5.0],
    [5.0, 2.0],
    [3.0, 7.0],
])

# На старті вважаємо всі точки недомінованими.
pareto_mask = np.ones(
    len(points),
    dtype=bool,
)

for i in range(len(points)):
    for j in range(len(points)):
        # Точку не порівнюємо із самою собою.
        if i == j:
            continue

        # Якщо j домінує i, кандидат i вилучаємо.
        if dominates(
            points[j],
            points[i],
        ):
            pareto_mask[i] = False
            break

# Очікуємо A, B і C. Точка D повинна зникнути.
print(
    points[pareto_mask]
)
Очікувано:
[[1. 8.]
 [2. 5.]
 [5. 2.]]
Цей результат потрібно зіставити з ручною перевіркою. Така незалежність важлива: код реалізує означення, а маленька таблиця дозволяє перевірити реалізацію без довіри до самого коду.
13. Зважена сума, перевірка та результат
Для наскрізної неперервної задачі аналітичний розв’язок відомий:
Тому код можна перевірити без чисельного оптимізатора:
def weighted_solution(weight):
    # Формула отримана аналітично зі стаціонарності зваженої цілі.
    return 4.0 * (1.0 - weight)


weights = [
    0.0,
    0.25,
    0.5,
    0.75,
    1.0,
]

for weight in weights:
    # Обчислюємо компромісне рішення для поточної ваги.
    x_star = weighted_solution(weight)

    # Повторно обчислюємо обидва початкові критерії.
    f1 = x_star ** 2
    f2 = (x_star - 4.0) ** 2

    # Виводимо всі величини, потрібні для перевірки компромісу.
    print(
        weight,
        x_star,
        f1,
        f2,
    )
Для \(w=0.5\) очікуємо:
0.5 2.0 4.0 4.0
Незалежна перевірка складається з кількох кроків. Спочатку перевіряємо межі:
Далі повторно обчислюємо \(f_1(x^*)\) і \(f_2(x^*)\). Для зваженої суми можна також перевірити стаціонарність:
Для набору дискретних кандидатів повторно запускаємо перевірку домінування. Остаточна точка, яку називаємо Парето-оптимальною відносно набору, не повинна мати домінуючого конкурента в цьому наборі.
Мінімальний машинозчитуваний блок може мати вигляд:
STATUS: OK
DECISION: ...
OBJECTIVES: [...]
DOMINATED: False
SCALARIZATION_METHOD: weighted_sum
WEIGHTS: [...]
NORMALIZATION_RULE: ...
TOLERANCE: ...
Якщо використано метод епсилон-обмеження, замість ваг зберігаємо значення \(\varepsilon\) та точний запис відповідного обмеження.
Інтерпретація, межі та підсумок
14. Як читати Парето-результат і де легко помилитися
Парето-оптимальна точка означає відсутність однозначно кращого допустимого рішення за всіма критеріями. Цей статус не містить готового управлінського рішення. Дві Парето-точки можуть представляти дуже різні компроміси, і вибір між ними потребує додаткових пріоритетів.
Типова помилка виникає, коли однакові ваги використовують для критеріїв із різними масштабами. Наприклад, 0.5 для вартості в сотнях тисяч і 0.5 для часу в годинах не дають симетричного змістового впливу. Перед інтерпретацією потрібне обґрунтоване нормування.
Ще одна проблема пов’язана з напрямами критеріїв. Якщо частину показників мінімізують, а частину максимізують, правило домінування повинно враховувати цей факт. Найпростіше привести критерії до спільного напряму та задокументувати перетворення.
Серія зважених сум може показати значну частину фронту, але для неопуклої геометрії цього недостатньо. Відсутність точки серед результатів для вибраних ваг не доводить її домінованість. Метод епсилон-обмеження або інша скаляризація може відкрити додаткові компроміси.
Фінальний вибір варто формулювати окремим правилом. Наприклад: «серед Парето-рішень із часом доставки не більше 8 годин вибираємо мінімальну вартість». Тоді предметний пріоритет стає частиною моделі й може бути перевірений.
Ще один корисний спосіб читання фронту — аналіз приростів. Якщо перехід від рішення A до B зменшує вартість на 1000 гривень, але збільшує час на 20 хвилин, предметний фахівець уже бачить конкретну ціну компромісу. Наступний перехід може давати лише 50 гривень економії за ті самі 20 хвилин. Такі порівняння часто зрозуміліші за самі координати фронту.
Для сусідніх Парето-точок можна також оцінити відношення змін критеріїв:
Це число описує локальну ціну покращення одного показника через погіршення іншого. Його предметний сенс залежить від одиниць, тому після нормування та в початкових одиницях воно може мати різну інтерпретацію. У звіті важливо явно вказати, в якій шкалі виконано такий розрахунок.
Для великої кількості критеріїв візуалізація ускладнюється, але принцип залишається тим самим. Потрібно показати значення кожного критерію, пояснити правило відбору недомінованих точок і відокремити математичну фільтрацію від фінального вибору. Це робить результат придатним для обговорення з людиною, яка відповідає за предметне рішення.
Інтерактивна самоперевірка лекції
Пройдіть 10 коротких питань. Після кожної відповіді ви побачите пояснення, а за потреби — підказку й повний розбір.
15. Підсумок
Багатокритеріальна оптимізація працює з вектором критеріїв, тому порівняння рішень починається з формального правила домінування. Доміновані рішення можна вилучити без втрати раціональних компромісів. Недоміновані рішення утворюють Парето-множину, а їхні значення критеріїв — фронт Парето.
Наскрізний приклад із \(f_1(x)=x^2\) та \(f_2(x)=(x-4)^2\) показує чистий конфлікт двох цілей. Увесь інтервал \([0,4]\) є Парето-множиною, бо рух уздовж нього покращує один критерій і водночас погіршує інший. Зважена сума дає явну формулу \(x^*(w)=4(1-w)\) і дозволяє простежити, як числовий пріоритет переміщує компроміс уздовж фронту.
Ваги потрібно інтерпретувати разом із напрямами, одиницями та масштабуванням критеріїв. Метод епсилон-обмеження дає інший спосіб задати пріоритет через предметно зрозумілу межу. Для неопуклого фронту він також може знайти точки, які звичайна зважена сума пропускає.
Практична перевірка включає допустимість рішення, повторне обчислення всіх критеріїв, контроль домінування, збереження допуску та документування способу скаляризації. Після побудови Парето-набору математична частина завершується прозорим описом компромісів, а фінальний вибір виконується за окремо сформульованими предметними пріоритетами.
Чисельна надійність та аудит оптимізаційного розв’язку
Коротко про лекцію
Завершальний розділ збирає чисельний аудит оптимізаційного розв’язку в єдину процедуру. Ви навчитеся перевіряти статус, допуски, нев’язки, обмеження, цільову функцію та відтворюваність результату перед практичним використанням.
Практичний сенс. Правильна математична формула ще не гарантує надійного чисельного результату. Дані мають скінченну точність, алгоритми зупиняються за допусками, а погано обумовлена задача може сильно підсилити малу похибку. Тому завершення курсу присвячене системному аудиту: модель → результат → нев’язки → чутливість → інтерпретація.
Постановка та базові поняття
1. Чому правильна формула ще не гарантує правильне число
Комп’ютер зберігає більшість дійсних чисел наближено. Навіть прості операції можуть накопичувати похибку округлення. Крім того, чисельний метод може зупинитися до точного виконання математичних умов.
Тому результат треба оцінювати системою незалежних перевірок. Кількість десяткових знаків сама по собі не є показником надійності.
Чисельна оптимізація поєднує математичну модель, алгоритм і арифметику комп’ютера. Помилка може виникнути на кожному рівні. Формула може бути правильною, але дані переплутані. Алгоритм може завершитися коректно, але для іншої знакової домовленості. Обчислення можуть втрачати точність через погане масштабування.
Тому фінальний результат потрібно розглядати як твердження, яке має пройти аудит. Запитання «яке число повернула бібліотека?» є лише одним етапом. Далі потрібно з’ясувати, чи виконує точка початкові обмеження, чи узгоджується значення цілі, чи малі нев’язки оптимальності та чи не є задача надмірно чутливою.
Ця лекція збирає перевірки з усього курсу в єдину послідовність.
1.1. Чим відрізняються похибка, нев’язка та число обумовленості
Похибка порівнює обчислений результат із правильним значенням, якщо воно відоме.
Нев’язка відповідає на інше запитання: наскільки знайдений результат виконує вихідне рівняння, обмеження або умову стаціонарності після підстановки.
Число обумовленості показує, наскільки сильно мала зміна вхідних даних може змінити розв’язок. Тому мала нев’язка не завжди означає малу похибку в погано обумовленій задачі.
2. Чисельна надійність
Чисельно надійний результат має кілька рівнів доказів:
- математична модель правильна;
- дані та одиниці узгоджені;
- алгоритм завершився зрозумілим статусом;
- точка допустима;
- умови оптимальності виконані в межах допуску;
- задача не надто чутлива або ця чутливість врахована;
- результат можна відтворити.
3. Арифметика з рухомою комою
Числа типу float64 мають обмежену кількість значущих бітів. Наприклад, десяткове число 0.1 не має точного скінченного
двійкового подання.
Тому перевірка:
# Демонструємо, що двійкова арифметика з рухомою комою може порушити очікуване десяткове порівняння.
0.1 + 0.2 == 0.3
може дати False.
Це властивість двійкового подання чисел у машинній арифметиці Python.
Комп’ютер зберігає більшість дійсних чисел скінченною кількістю бітів. Значення на кшталт \(0.1\) не мають точного двійкового представлення, тому після операцій з’являються малі похибки округлення.
Через це перевірка a == b для результатів чисельної оптимізації часто є невдалою ідеєю. Математична рівність
замінюється перевіркою з допуском.
Проблема стає серйознішою, коли віднімаються близькі великі числа або поєднуються дуже різні масштаби. Тоді частина значущих цифр може втрачатися.
Числовий допуск не виправляє довільну похибку. Він лише визначає межу, в якій відхилення вважається прийнятним для конкретного масштабу та методу.
4. Абсолютний числовий допуск
Проста перевірка:
добре працює, коли всі величини мають подібний масштаб.
Наприклад, різниця \(10^{-8}\) є малою порівняно з одиницею, але може бути великою порівняно з \(10^{-10}\).
5. Відносний числовий допуск
Для великих значень зручно враховувати масштаб:
Так перевірка має абсолютну частину біля нуля та відносну частину для великих чисел.
Абсолютний допуск добре працює для величин одного масштабу. Якщо порівнюємо числа порядку \(10^9\), різниця \(0.01\) може бути відносно мізерною. Для чисел порядку \(10^{-8}\) та сама різниця величезна.
Тому часто використовують комбіноване правило:
Абсолютна частина захищає порівняння поблизу нуля, а відносна масштабує допустиму різницю для великих значень.
У перевіряльнику краще давати допускам імена за змістом: FEASIBILITY_TOL, GRADIENT_TOL, OBJECTIVE_TOL. Різні
математичні умови можуть потребувати різних порогів.
6. Похибка та нев’язка на простому рівнянні
Нехай треба розв’язати:
Для знайденого \(\widehat x\) нев’язка:
і можна оцінити:
Якщо точний \(x^*\) відомий, можна також обчислити пряму похибку:
У реальній задачі точний \(x^*\) часто невідомий, тому нев’язка практично доступніша.
Математична логіка
7. Число обумовленості
Для невиродженої матриці у вибраній нормі:
Для симетричної додатно визначеної матриці в евклідовій нормі:
Велике число означає сильну потенційну чутливість.
Число обумовленості описує чутливість задачі до малих змін даних. Воно є властивістю математичної постановки, а не конкретного чисельного алгоритму.
Для лінійної системи \(Ax=b\) велике \(\kappa(A)\) означає, що невелике відносне збурення \(A\) або \(b\) може спричинити значно більшу відносну зміну розв’язку. Для симетричної додатно визначеної матриці відношення найбільшого та найменшого власних значень дає зрозумілий геометричний образ витягнутих рівнів.
Важливо не трактувати число обумовленості як абсолютний вирок. Його значення потрібно читати разом із точністю даних, масштабом і вимогами задачі. Проте різке зростання \(\kappa\) є сигналом для масштабування, регуляризації або перегляду моделі.
8. Наскрізний погано обумовлений приклад
Розглянемо:
Матриця Гессе:
Число обумовленості:
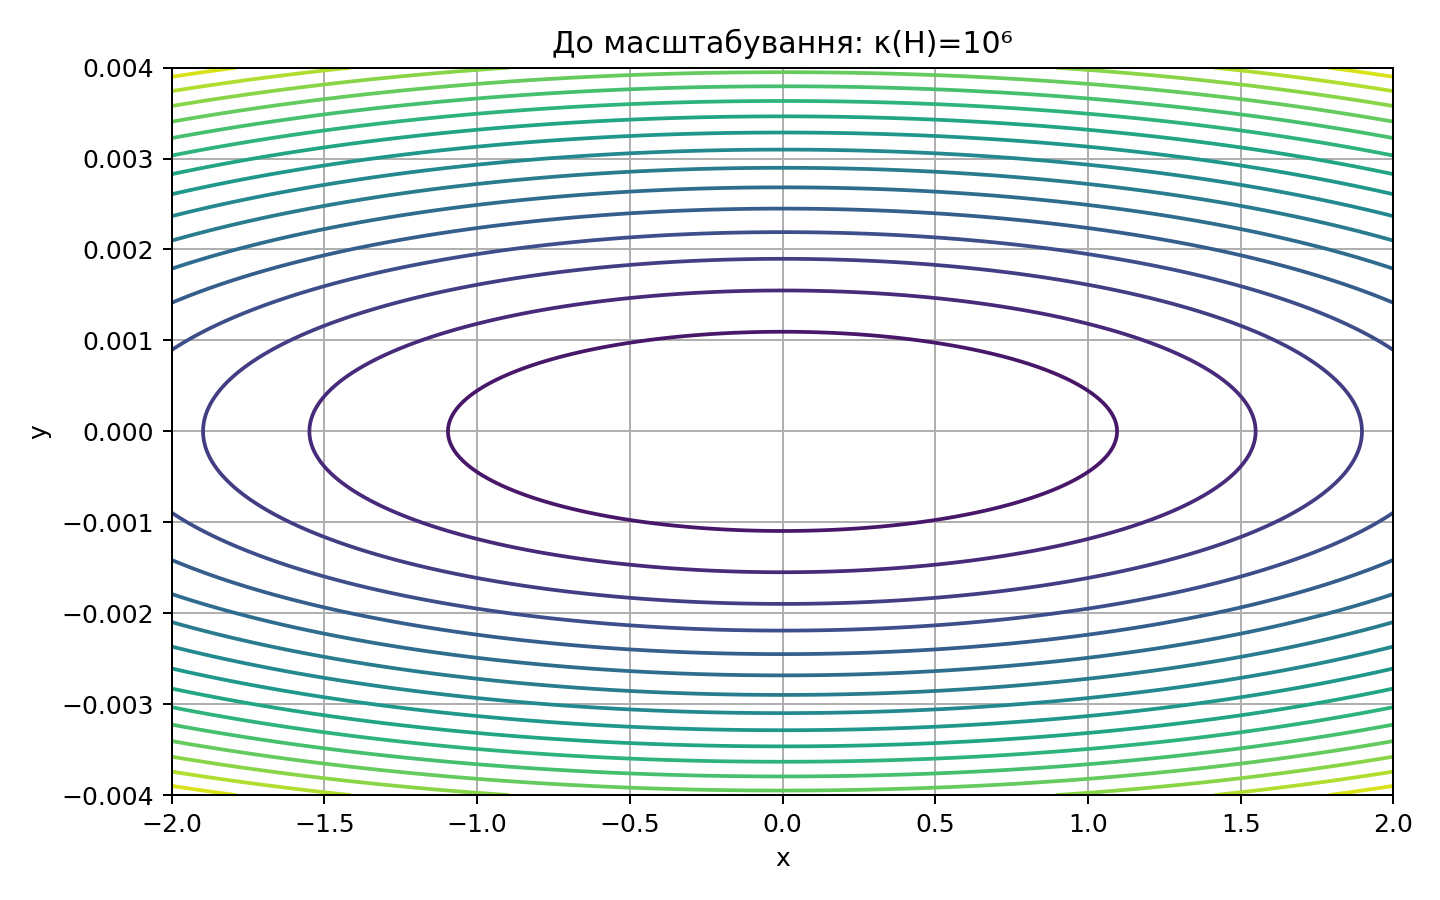
Лінії рівня дуже витягнуті. Градієнтний метод бачить зовсім різні масштаби кривизни за координатами.
Розглянемо:
Матриця Гессе:
має власні значення 1 і \(10^6\). Тому:
Рівні функції є дуже витягнутими еліпсами. Уздовж \(y\) ціль змінюється у мільйон разів швидше, ніж уздовж \(x\).
Градієнтний метод із одним кроком змушений бути достатньо обережним для крутого напряму \(y\). Через це прогрес уздовж \(x\) може бути повільним. Цей приклад показує, як геометрія безпосередньо переходить у поведінку алгоритму.
9. Масштабування координати
Введемо нову змінну:
Тоді:
Після підстановки:
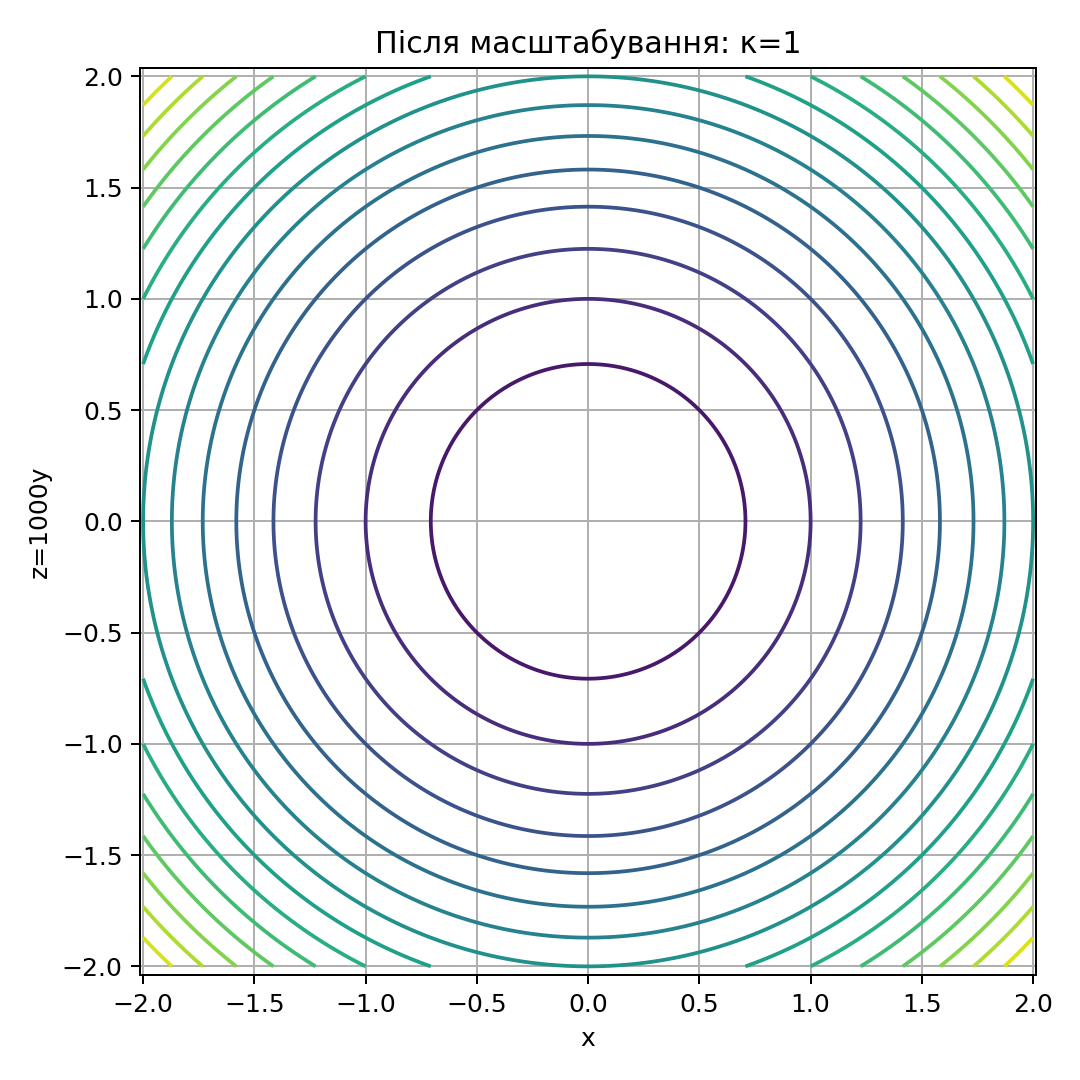
Матриця Гессе стає одиничною, а число обумовленості — 1.
Введемо нову змінну:
тоді:
Після підстановки:
Матриця Гессе в нових координатах стає одиничною, а число обумовленості дорівнює 1.
Математична фізична точка не змінилася — змінився спосіб її координатного опису. Алгоритм тепер бачить однакові масштаби кривизни.
Після розв’язання результат потрібно повернути до початкових одиниць через \(y=z/1000\). Тому параметри масштабування мають бути частиною відтворюваного опису.
10. Що саме змінилося
Ми не змінили фізичний розв’язок. Ми лише виразили другу координату в іншому масштабі. Після обчислення значення \(z\) треба повернути до початкової змінної \(y\).
Масштабування є коректним, якщо між старими та новими координатами існує однозначне перетворення і предметний зміст зберігається.
11. Масштабування обмежень
Подібна проблема виникає в рядках обмежень. Одне рівняння може містити коефіцієнти порядку \(10^6\), інше — \(10^{-4}\). Помноження рівняння на ненульову константу не змінює його множину розв’язків, але змінює числовий масштаб коефіцієнтів.
Тому іноді корисно нормувати рядки, не змінюючи їхнього змісту.
12. Чому мала нев’язка не завжди означає точний розв’язок
У добре обумовленій задачі мала нев’язка зазвичай узгоджується з малою похибкою. У погано обумовленій задачі невелика зміна правої частини може викликати велику зміну розв’язку.
Тому два показники треба читати разом: нев’язка показує виконання рівнянь, число обумовленості — чутливість розв’язку.
Для системи \(Ax=b\) нев’язка:
показує, наскільки добре кандидат виконує рівняння. Пряма похибка:
показує відстань до точного розв’язку. Це різні величини.
У добре обумовленій задачі мала нев’язка зазвичай підтримує висновок про малу похибку. У погано обумовленій задачі матриця може сильно підсилювати певні напрями похибки, тому малий \(r\) співіснує з помітним \(e\).
Через це перевірка чисельного результату повинна містити і нев’язки, і показники обумовленості. Нев’язка відповідає на питання «чи виконується рівняння?», а обумовленість — «наскільки цей факт контролює точність самого розв’язку?».
13. Обернена похибка
Ще одне корисне запитання: для яких трохи змінених даних обчислений результат був би точним? Величину такого збурення називають оберненою похибкою.
Чисельно стійкий алгоритм часто можна тлумачити як такий, що точно розв’язує близьку задачу. Якщо сама задача добре обумовлена, це дає малу пряму похибку. Якщо задача погано обумовлена, навіть дуже стійкий алгоритм не може усунути чутливість, закладену в даних.
14. Критерій зупинки як частина методу
Чисельний метод повинен мати явний критерій зупинки. Потрібно назвати конкретну нев’язку та конкретний допуск.
Для задачі без обмежень це може бути:
Для рівностей — нев’язка \(Ax-b\). Для KKT — окремі нев’язки допустимості, стаціонарності та комплементарності.
15. Чому одного критерію зупинки недостатньо
Мала зміна точки може виникнути через надто малий крок. Мала зміна цільової функції може виникнути на пласкій ділянці далеко від стаціонарності. Досягнення максимальної кількості ітерацій взагалі не є доказом оптимальності.
Тому надійний алгоритм поєднує кілька критеріїв та повертає причину завершення.
Алгоритм і покроковий розбір
16. Аудит починається до запуску розв’язувача
Перед обчисленням треба перевірити:
- порядок змінних;
- одиниці вимірювання;
- знаки обмежень;
- розміри масивів;
- скінченність вхідних значень;
- структурні припущення методу;
- масштаб коефіцієнтів.
Багато «чисельних» проблем насправді виникають через помилку моделі або даних.
Перший етап аудиту стосується даних і моделі. Потрібно перевірити розміри масивів, порядок змінних, одиниці вимірювання, знаки цілі та обмежень, скінченність усіх чисел і відсутність очевидних суперечностей.
Далі корисно підставити одну просту тестову точку, значення якої можна порахувати вручну. Це перевіряє відповідність формули та коду до запуску складного алгоритму.
Для матричних моделей окремо перевіряються симетрія, ранг, власні значення або інші структурні властивості. Якщо задача декларується опуклою, це твердження повинно мати математичну основу.
Такий передстартовий аудит часто ловить помилку дешевше, ніж аналіз дивної поведінки чисельного методу.
17. Статус розв’язувача
Статус пояснює, чому алгоритм завершився. Можливі змістовні категорії:
OPTIMAL
INFEASIBLE
UNBOUNDED
MAX_ITERATIONS
NUMERICAL_FAILURE
Конкретні назви залежать від бібліотеки. У власному звіті їх можна приводити до єдиної внутрішньої класифікації.
Статус пояснює причину завершення алгоритму. Типові стани можуть означати успіх, досягнення ліміту ітерацій, недопустимість, необмеженість або чисельну проблему.
Статус потрібно читати до використання значень змінних. Якщо алгоритм завершився через ліміт ітерацій, повернена точка може бути корисним наближенням, але її не слід автоматично називати оптимальною.
Навіть статус успіху потребує незалежної перевірки. Бібліотека перевіряє ту модель, яку отримала. Вона не знає, чи правильно користувач переніс предметну постановку.
Тому статус є першим полем результату, а не фінальним доказом.
18. Перевірка допустимості
Для нерівностей \(g_i(x)\le0\):
Для рівностей:
Для меж змінних перевіряють нижні та верхні порушення окремо або включають їх у загальний список нерівностей.
19. Перевірка стаціонарності
Для задачі без обмежень:
Для задачі з рівностями використовують градієнт функції Лагранжа. Для KKT додають активні нерівності та їхні множники.
Отже, слово «стаціонарність» має одну ідею, але конкретна формула залежить від класу задачі.
20. Перевірка найменших квадратів
Для методу найменших квадратів корисно зберігати:
- вектор залишків;
- SSE або RMSE;
- \(\|A^Tr\|\);
- ранг матриці;
- сингулярні значення;
- число обумовленості.
Мала SSE не гарантує стабільні параметри при майже залежних стовпцях.
21. Перевірка KKT
Для задачі з обмеженнями зберігають окремо:
- пряму нев’язку;
- двоїсту нев’язку;
- нев’язку стаціонарності;
- нев’язку комплементарності.
Їхній максимум зручний для автоматичного рішення «пройдено/не пройдено», але окремі величини потрібні для діагностики.
Для задачі з гладкими нерівностями аудит збирає чотири групи нев’язок: пряму, двоїсту, стаціонарну та комплементарну.
Корисний агрегат:
показує найгіршу складову. Якщо задача опукла й умови регулярності виконані, малий KKT-залишок разом зі структурним аналізом підтримує сильний висновок про глобальний оптимум.
Для неопуклої задачі KKT перевіряє лише локальні необхідні умови. Тому поле KKT_RESIDUAL повинно супроводжуватися
інформацією про клас задачі.
22. Повторне обчислення цільової функції
Не варто покладатися лише на поле результату чисельної бібліотеки. Потрібно повторно обчислити цільову функцію за початковою математичною формулою та повернутими координатами.
Це допомагає знайти пропущену сталу, неправильний знак або переплутаний порядок коефіцієнтів.
Чисельний розв’язувач може повертати значення цілі окремим полем. Перевіряльник повинен повторно обчислити його з початкової математичної формули.
Для задачі максимізації, яку бібліотека внутрішньо перетворює на мінімізацію, це особливо важливо. Помилка знака може дати правильний вектор змінних у простому прикладі, але неправильне повідомлене значення.
Порівнюємо:
з окремим допуском цілі.
Також потрібно враховувати сталі доданки, які не впливають на мінімізатор, але впливають на числове значення цільової функції.
23. Чутливість до стартової точки
У неопуклих задачах різні початкові точки можуть приводити до різних локальних мінімумів. Тому корисно виконувати кілька запусків і порівнювати допустимі результати.
У опуклій задачі різні старти можуть змінити кількість ітерацій, але не повинні змінювати глобальний оптимум за коректного алгоритму.
Для опуклої задачі з єдиним мінімізатором різні розумні стартові точки повинні приводити до того самого результату в межах допуску. Якщо результати сильно відрізняються, це сигналізує про проблеми алгоритму, реалізації або критеріїв зупинки.
Для неопуклої задачі різні старти можуть законно приводити до різних локальних мінімумів. Тоді серія запусків стає частиною дослідження структури задачі.
У звіті корисно зберігати стартову точку та фінальне значення цілі для кожного запуску. Це дозволяє відрізнити стабільний алгоритм від випадкового вдалого старту.
24. Чутливість до параметрів алгоритму
Крок, допуски, максимальна кількість ітерацій та параметри пошуку довжини кроку впливають на чисельну поведінку. Тому їх треба зберігати у звіті.
Порівнювати два методи за кількістю ітерацій можна лише при однакових критеріях зупинки та з урахуванням вартості однієї ітерації.
Довжина кроку, допуски, максимальна кількість ітерацій та параметри пошуку впливають на чисельну траєкторію. Невелика зміна цих налаштувань не повинна радикально змінювати математичний результат добре поставленої опуклої задачі.
Якщо зменшення допуску суттєво змінює розв’язок, попередня точність могла бути недостатньою. Якщо результат нестабільний при невеликих змінах масштабу, варто перевірити обумовленість.
Аудит параметрів не означає перебирати все без системи. Потрібно змінювати один фактор і спостерігати, яка метрика реагує: ціль, допустимість, градієнт, кількість ітерацій або KKT-нев’язка.
Програмна реалізація та перевірка
25. Число обумовленості в NumPy
# Імпортуємо NumPy для обчислень, розв’язання моделі та її перевірки.
import numpy as np


# Задаємо матрицю кривизни у фіксованому порядку змінних.
hessian = np.array([
    [1.0, 0.0],
    [0.0, 1e6],
])

# Оцінюємо число обумовленості, щоб побачити чутливість задачі до малих числових похибок.
condition_number = np.linalg.cond(
    hessian
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print(condition_number)
Очікувано:
1000000.0
26. Перевірка скінченності
# Перевіряємо, що масив не містить NaN або нескінченностей перед математичним аудитом.
def all_finite(array):
    # np.isfinite перевіряє кожний елемент, а np.all вимагає успіху для всього масиву.
    return bool(
        np.all(
            np.isfinite(array)
        )
    )
Цю перевірку варто робити до порівняння з числовими допусками.
27. Іменовані допуски
Не варто розкидати 1e-6 по різних місцях коду без пояснення. Краще використовувати іменовані параметри:
# Обчислюємо чисельну діагностику для фінального аудиту.
FEASIBILITY_TOLERANCE = 1e-6
GRADIENT_TOLERANCE = 1e-6
KKT_TOLERANCE = 1e-6
Різні нев’язки можуть потребувати різних масштабів.
28. Універсальні метрики перевірки
# Обчислюємо максимальне порушення нерівностей у єдиній знаковій домовленості.
def max_inequality_violation(values):
    values = np.asarray(
        values,
        dtype=float,
    )

    # Повертаємо результат допоміжного обчислення у погодженому числовому форматі.
    return float(
        np.max(
            np.maximum(values, 0.0)
        )
    )


# Виносимо окрему математичну операцію в допоміжну функцію, щоб її було легко перевірити.
def vector_norm(values):
    values = np.asarray(
        values,
        dtype=float,
    )

    # Повертаємо результат допоміжного обчислення у погодженому числовому форматі.
    return float(
        np.linalg.norm(values)
    )
Функції залишають математичний зміст видимим: одна вимірює порушення нерівностей, інша — норму вектора нев’язки.
29. Панель нев’язок
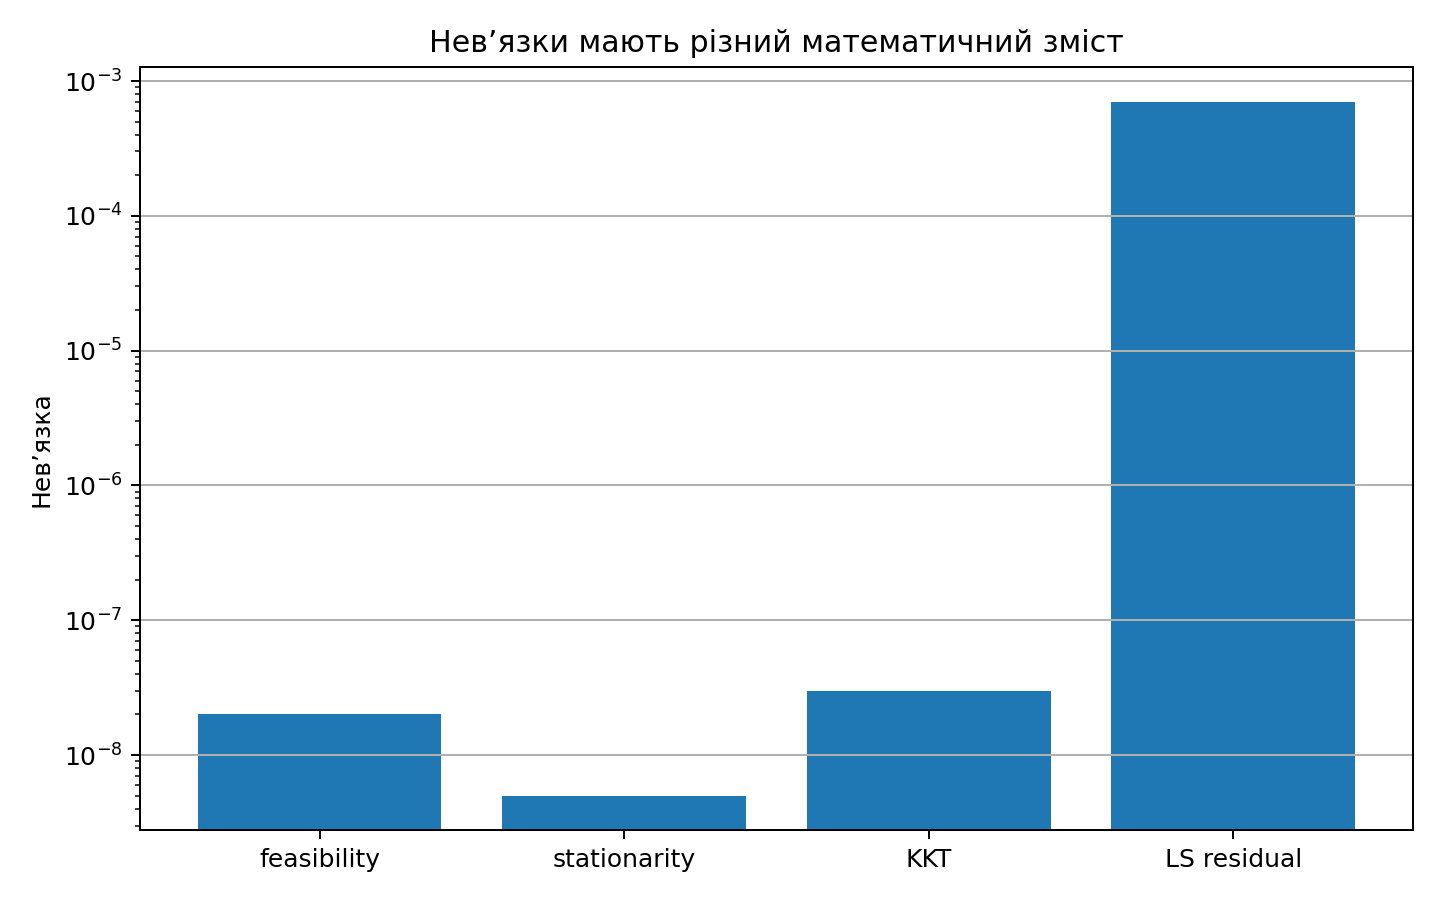
Різні нев’язки мають різний зміст і різні одиниці. Тому однакове число \(10^{-4}\) може бути прийнятним для однієї умови та надто великим для іншої.
30. Машиночитний блок результату
Для різних класів задач можна використовувати поля:
VARIANT
STATUS
X
OBJECTIVE
MAX_CONSTRAINT_VIOLATION
RESIDUAL
GRAD_NORM
DUALITY_GAP
KKT_RESIDUAL
ITERATIONS
Невикористовувані поля можна пропустити. Важливо, щоб кожне поле мало чітке математичне визначення.
Структурований блок результату дозволяє автоматично перевіряти різні класи задач. Наприклад:
STATUS: OPTIMAL
X: [...]
OBJECTIVE: ...
MAX_CONSTRAINT_VIOLATION: ...
GRAD_NORM: ...
DUALITY_GAP: ...
KKT_RESIDUAL: ...
ITERATIONS: ...
Не кожне поле потрібне для кожної задачі. У лінійному програмуванні корисний розрив двоїстості, у гладкій задачі без обмежень — норма градієнта, у задачі з нерівностями — KKT-нев’язка.
Формат повинен мати стабільні назви та одиниці вимірювання. Тоді автоматична перевірка може відрізняти математичні критерії від текстового оформлення.
31. Відтворюваність
Для повторення обчислення зберігають:
- вхідні дані;
- версію Python;
- версії бібліотек;
- назву методу;
- початкову точку;
- допуски;
- максимальну кількість ітерацій;
- параметри чисельного розв’язувача.
Для випадкових алгоритмів додають початкове значення генератора випадкових чисел.
Відтворюваний результат означає, що інша людина може повторити обчислення з тими самими даними та налаштуваннями. Для цього потрібно зберегти початкові дані, порядок змінних, версію моделі, метод, ключові параметри, допуски й точні числові результати до округлення.
Якщо алгоритм використовує випадковість, фіксують початковий стан генератора випадкових чисел. Для детермінованого методу це поле не потрібне.
Версії бібліотек важливі тоді, коли реалізаційні деталі можуть змінити траєкторію або статус. Проте математичний перевіряльник повинен залишатися стабільним: допустимість і ціль обчислюються з початкової моделі.
Відтворюваність перетворює одноразовий результат на технічний доказ, який можна перевірити пізніше.
Інтерпретація, межі та підсумок
32. Типові помилки
Типова помилка. Успішний статус чисельного розв’язувача вважають доказом правильності. Статус є лише одним джерелом інформації.
Інша помилка — округлювати координати до перевірки обмежень. Раннє округлення може змінити активний набір або створити штучне порушення.
33. Кілька оптимальних розв’язків
Якщо задача має багато оптимальних точок, автоматична перевірка не повинна вимагати точного збігу одного вектора \(x\). Треба перевірити допустимість і значення цільової функції з допуском.
Для опуклої задачі додатково можна використати нев’язку KKT.
34. Що робити при статусі «недопустима задача»
Спочатку перевіряють знаки обмежень, одиниці вимірювання, дубльовані межі й суперечливі рівності. Якщо модель сформульована правильно, недопустимість є корисним результатом: задані вимоги не можуть бути виконані одночасно.
Це не обов’язково програмний збій.
35. Що означає необмеженість
Статус необмеженості означає, що цільову функцію можна поліпшувати без скінченної межі в допустимій області. Типові причини — відсутнє ресурсне обмеження або неправильний знак.
Перед прийняттям такого висновку корисно знайти або пояснити напрям необмеженого поліпшення.
36. Перевірка лінійного програмування
Для LP корисно перевіряти:
- пряму допустимість;
- значення цілі;
- двоїсту допустимість;
- розрив двоїстості.
Малий розрив двоїстості є сильним сертифікатом за відповідних умов.
37. Перевірка гладкої задачі без обмежень
Перевіряють:
- норму градієнта;
- історію цільової функції;
- довжини кроків;
- скінченність значень;
- кривизну поблизу кандидата, якщо матриця Гессе доступна.
У опуклій функції мала норма градієнта має глобальний зміст. У неопуклій — лише підтверджує стаціонарність.
38. Перевірка задачі з обмеженнями
Перевіряють усі обмеження, набір активних обмежень, множники, градієнт функції Лагранжа та нев’язки KKT. Якщо заявляється глобальний оптимум, потрібне обґрунтування опуклості або інша достатня теорема.
39. Чисельно стійкий алгоритм не виправляє погану задачу
Навіть найкращий алгоритм не може створити інформацію, якої немає в даних. Якщо стовпці матриці майже залежні, параметри природно чутливі. Алгоритм може не додавати зайвої похибки, але число обумовленості все одно обмежує кількість надійних цифр.
Регуляризація може зменшити цю чутливість, але вона вже змінює саму оптимізаційну задачу.
Стабільний алгоритм намагається не підсилювати чисельні похибки більше, ніж це необхідно. Проте він не може усунути фундаментальну чутливість самої задачі.
Якщо дані майже лінійно залежні, розв’язок може бути нестабільним навіть при якісній реалізації. Якщо модель має неправильні одиниці або суперечливі обмеження, кращий алгоритм лише швидше розв’яже неправильну постановку.
Тому чисельна надійність має два рівні. Перший — добре поставлена й масштабована математична модель. Другий — алгоритм і реалізація, які поважають цю структуру.
У фінальному аудиті потрібно перевіряти обидва рівні окремо.
Інтерактивна самоперевірка лекції
Пройдіть 10 коротких питань. Після кожної відповіді ви побачите пояснення, а за потреби — підказку й повний розбір.
40. Підсумок
Чисельна надійність вимагає розрізняти похибку, нев’язку та обумовленість. Похибка порівнює результат із точним розв’язком, якщо він відомий, нев’язка вимірює виконання конкретної математичної умови, а число обумовленості показує чутливість задачі до малих змін даних. Мала нев’язка в погано обумовленій задачі ще не гарантує малу похибку.
Масштабування може суттєво змінити чисельну геометрію без зміни предметного змісту моделі. У наскрізному прикладі матриця Гессе \(\operatorname{diag}(1,10^6)\) має число обумовленості \(10^6\), а після заміни \(z=1000y\) воно зменшується до 1. Після розв’язання масштабованої задачі результат потрібно повернути до початкових одиниць.
Фінальний аудит збирає статус, допустимість, повторно обчислену ціль, відповідні нев’язки, допуски, кількість ітерацій і чутливість до параметрів алгоритму. Для різних класів задач використовуються різні сертифікати, тому кожне поле звіту повинно мати математичне означення. Робочий цикл усього курсу завершується послідовністю «постановка → модель → метод → обчислення → перевірка → інтерпретація».