Лекція 28. Регуляризація та стабілізація оцінювання
Коротко про лекцію
Лекція пояснює, чому майже залежні ознаки роблять оцінки нестійкими. Ви побачите, як Ridge-регуляризація додає штраф до моделі, зменшує чутливість коефіцієнтів і створює контрольований компроміс між точністю та стабільністю.
Практичний сенс. Іноді модель добре підганяє навчальні дані, але параметри стають надто великими або дуже чутливими до малого шуму. Регуляризація додає до цільової функції штраф за небажану складність параметрів. Це створює керований компроміс між точністю підгонки та стабільністю.
Постановка та базові поняття
1. Навіщо додавати штраф
Припустімо, дві майже однакові змінні в моделі можуть взаємно компенсуватися. Тоді невелика зміна даних здатна сильно змінити окремі коефіцієнти, хоча прогноз майже не зміниться.
У такій ситуації мала похибка підгонки ще не означає надійні параметри. Потрібна додаткова вимога до самих параметрів.
У звичайному методі найменших квадратів параметри визначаються лише якістю підгонки. Якщо дані містять майже залежні ознаки, багато різних наборів параметрів можуть давати дуже схожі прогнози. Невелика зміна даних тоді здатна сильно змінити самі коефіцієнти.
Регуляризація вводить додаткову перевагу: серед рішень із подібною підгонкою віддавати перевагу параметрам контрольованого розміру. Для квадратичного штрафу додаємо \(\lambda\|\theta\|_2^2\).
Параметр \(\lambda\ge0\) керує силою цієї переваги. При \(\lambda=0\) отримуємо початкову задачу. Зі зростанням \(\lambda\) штраф сильніше впливає на рішення.
Це свідома зміна математичної моделі. Тому регуляризований розв’язок потрібно оцінювати за двома складовими: якістю підгонки та величиною штрафу.
1.1. Що означає регуляризація
Регуляризація додає до цілі штрафний доданок, який віддає перевагу певним властивостям параметрів: малим нормам, гладкості, розрідженості або іншій структурі.
Квадратичний штраф:
називають гребеневою регуляризацією. Далі використовуватимемо цей український термін.
Параметр \(\lambda\ge0\) визначає силу компромісу: мале \(\lambda\) більше довіряє даним, велике — сильніше стискає параметри.
2. Найпростіший одновимірний приклад
Розглянемо без регуляризації:
Мінімізатор:
Додамо штраф:
3. Знайдемо мінімізатор аналітично
Похідна:
Умова стаціонарності:
Тому:
Це ключова формула лекції.
4. Як параметр регуляризації змінює розв’язок
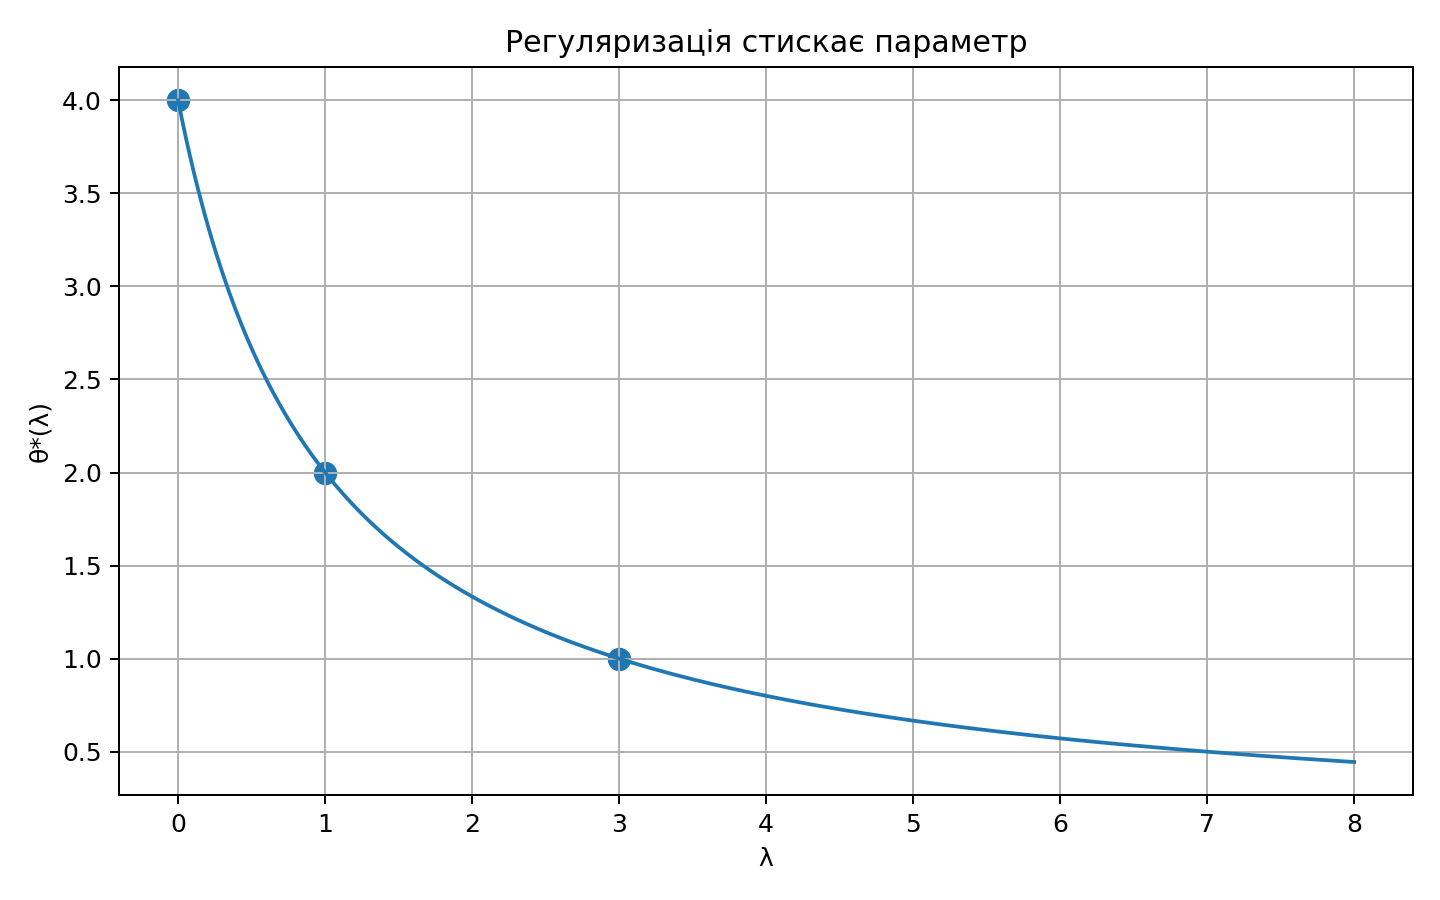
Для \(\lambda=0\):
Для \(\lambda=1\):
Для \(\lambda=3\):
При зростанні \(\lambda\) модуль параметра зменшується.
5. Що означає «стиснення»
Регуляризація навмисно зміщує параметр у бік простішого значення, щоб зменшити чутливість до шуму.
Це компроміс. Підгонка до навчальних даних зазвичай погіршується, але стабільність та поведінка на нових даних можуть поліпшитися.
У скалярному прикладі:
модуль параметра зменшується зі зростанням \(\lambda\). Таку поведінку називають стисканням параметрів.
Стиснення не означає механічне округлення коефіцієнта до нуля. Для квадратичної регуляризації параметр зазвичай плавно наближається до нуля. Це відрізняє її від деяких інших штрафів, які можуть давати точні нульові коефіцієнти.
Геометрично вихідна ціль тягне параметр до значення, яке найкраще пояснює дані, а регуляризатор тягне його до центру штрафу. Оптимум виникає як баланс цих двох тенденцій.
Тому \(\lambda\) має предметний зміст компромісу і виходить за межі звичайного числового налаштування алгоритму.
Математична логіка
6. Регуляризовані найменші квадрати
Для задачі з лекції 27:
додамо квадратичний штраф:
Для векторної моделі ціль має вигляд:
Перша частина вимірює невідповідність даним. Друга штрафує великі коефіцієнти. Обидві частини квадратичні, тому задача залишається опуклою.
Якщо \(A\) має дефіцит рангу, звичайна матриця \(A^TA\) може бути виродженою. При \(\lambda>0\) матриця:
стає додатно визначеною. Це дає єдиний розв’язок навіть тоді, коли звичайні найменші квадрати мають неєдиний вектор параметрів.
Отже, регуляризація одночасно змінює предметну перевагу та покращує математичну структуру системи.
7. Градієнт регуляризованої цілі
Стаціонарність:
Отже:
8. Чому регуляризація покращує обумовленість
Нехай власні значення \(A^TA\) дорівнюють \(\sigma_i^2\). Після додавання \(\lambda I\) вони стають:
Малі власні значення збільшуються. Тому відношення найбільшого власного значення до найменшого часто зменшується.
Це математичне пояснення стабілізації.
Нехай власні значення матриці \(A^TA\) дорівнюють \(\gamma_1,\dots,\gamma_n\) і є невід’ємними. Після додавання \(\lambda I\) вони стають:
Найменші значення отримують відносно найбільше підсилення. Якщо одне власне значення майже нульове, додавання навіть помірного \(\lambda\) відсуває систему від виродженості.
Для додатних власних значень число обумовленості регуляризованої системи:
зазвичай менше за початкове відношення. Через це розв’язок стає менш чутливим до малих збурень.
Однак надто велике \(\lambda\) може надмірно змістити параметри. Чисельна стабільність і точність моделі утворюють компроміс.
9. Простий приклад числа обумовленості
Нехай власні значення матриці без регуляризації дорівнюють 100 і 0.01. Тоді:
При \(\lambda=1\) маємо 101 і 1.01:
Обумовленість поліпшилася у сто разів.
10. Матриця штрафу
Не завжди потрібно однаково штрафувати всі параметри. Загальніша форма:
Матриця \(L\) визначає, які комбінації параметрів штрафуються.
Якщо \(L=I\), усі параметри штрафуються однаково. Якщо певний напрям не повинен штрафуватися, структуру \(L\) змінюють відповідно до моделі.
11. Чи штрафувати вільний член
У багатьох регресійних задачах вільний член не штрафують, бо він описує загальний рівень, а не складність залежності від ознак.
Тоді можна використати матрицю \(L\), у якій компонент вільного члена має нульовий штраф.
Це не універсальне правило. Вибір має відповідати предметному змісту та способу масштабування даних.
У лінійній моделі \(\widehat y=ax+b\) вільний член \(b\) часто має інший зміст, ніж коефіцієнти при ознаках. Якщо ознаки центровані, регуляризація нахилів контролює складність моделі, а сильний штраф для \(b\) може штучно тягнути середній рівень прогнозу до нуля.
Тому в багатьох практичних реалізаціях вільний член не штрафують. Тоді матриця регуляризації \(L\) або ваги штрафу мають нуль у відповідній позиції.
Це рішення повинно бути явним. Якщо в коді theta містить і нахили, і вільний член, вираз lambda * sum(theta ** 2) штрафує всі компоненти. Така реалізація може відрізнятися від задуманої математичної моделі.
Порядок параметрів і маска регуляризації є частиною відтворюваного опису задачі.
12. Масштаб ознак
Якщо одна ознака вимірюється тисячами, а інша — десятими частками, однаковий штраф на коефіцієнти може мати різний зміст.
Тому перед регуляризацією часто масштабують ознаки. Інакше числове значення \(\lambda\) не можна однаково тлумачити для різних координат.
Норма параметрів залежить від масштабу ознак. Якщо одну ознаку вимірювати в метрах, а іншу в міліметрах, коефіцієнти можуть відрізнятися в тисячу разів лише через одиниці вимірювання.
Однаковий квадратичний штраф тоді діє на параметри нерівномірно з предметного погляду. Тому перед регуляризацією часто стандартизують або масштабують ознаки.
Після масштабування потрібно зберегти параметри перетворення, щоб правильно інтерпретувати модель у початкових одиницях. Регуляризація і масштабування пов’язані, але виконують різні ролі: масштабування змінює координати, а штраф задає перевагу в цих координатах.
У навчальному прикладі масштаби прості. У реальній задачі цей крок може визначати зміст усього регуляризованого розв’язку.
13. Регуляризація і опуклість
Квадратичний штраф є опуклою функцією. Якщо початкова задача найменших квадратів опукла, додавання \(\lambda\|\theta\|_2^2\) з \(\lambda\ge0\) зберігає опуклість.
При \(\lambda>0\) і штрафуванні всіх напрямів ціль часто стає строго опуклою навіть тоді, коли \(A^TA\) має нульові власні значення.
14. Що регуляризація не виправляє
Регуляризація не може виправити неправильну предметну модель, переплутані стовпці або помилкові одиниці вимірювання. Вона змінює математичну задачу, щоб зробити параметри стабільнішими за певним критерієм.
Тому спочатку перевіряють модель і дані, а вже потім підбирають штраф.
Алгоритм і покроковий розбір
15. Три величини для кожного значення параметра регуляризації
Для кожного значення \(\lambda\) корисно обчислювати щонайменше:
- похибку підгонки \(\|A\theta-y\|_2^2\);
- норму параметрів \(\|\theta\|_2\);
- перевірку стаціонарності.
Якщо оцінюється чисельна стабільність, додають число обумовленості системної матриці.
Для кожного значення \(\lambda\) корисно зберігати щонайменше три величини:
- похибку підгонки \(\|A\theta-y\|_2^2\);
- норму параметрів \(\|\theta\|_2\);
- повну регуляризовану ціль.
Ці числа відповідають різним питанням. Похибка показує відповідність даним. Норма параметрів показує силу стискання. Повна ціль визначає оптимум для конкретного \(\lambda\).
Порівнювати повні цілі між різними \(\lambda\) безпосередньо не завжди змістовно, бо змінюється сама функція, яку мінімізуємо. Для вибору \(\lambda\) потрібен зовнішній критерій, наприклад помилка на відкладених даних.
Така таблиця робить компроміс видимим і захищає від вибору параметра лише за одним числом.
16. Траєкторія регуляризації
Замість одного значення \(\lambda\) можна розглянути послідовність:
Для кожного значення знаходять параметри й будують графіки. Така траєкторія показує, наскільки швидко параметри стискаються та де починає суттєво погіршуватися підгонка.
17. Чому використовують логарифмічну сітку
Вплив \(\lambda\) часто змінюється на кількох порядках величини. Сітка \(0.1,0.2,0.3\) може пропустити значну частину поведінки. Логарифмічна послідовність охоплює широкий діапазон.
Після грубого пошуку діапазон можна звузити.
Вплив \(\lambda\) часто змінюється на кількох порядках величини. Значення \(0.0001\), \(0.001\), \(0.01\), \(0.1\), \(1\), \(10\) і \(100\) охоплюють набагато ширший діапазон поведінки, ніж рівномірна сітка від 0 до 100.
Тому параметр регулярно досліджують у логарифмічній шкалі. Спочатку знаходять діапазон, де поведінка змінюється помітно, а потім за потреби уточнюють його.
Графік траєкторії параметрів за \(\log_{10}\lambda\) добре показує, які коефіцієнти стискаються швидко, а які залишаються стабільними.
У навчальному коді сітка повинна бути явною. Це робить експеримент відтворюваним і дозволяє порівнювати результати між різними реалізаціями.
18. Як вибирати параметр регуляризації
Найкраще значення \(\lambda\) не визначається лише навчальною похибкою. При \(\lambda=0\) навчальна підгонка зазвичай найкраща або не гірша.
Тому параметр регуляризації обирають за зовнішнім критерієм: відкладеними даними, перехресною перевіркою, предметними вимогами або відомим рівнем шуму.
Сам критерій оптимізації не визначає «правильне» \(\lambda\), бо для кожного значення виникає інша задача. Потрібен зовнішній принцип вибору.
У задачах прогнозування часто використовують валідаційні дані або перехресну перевірку. Для кожного кандидата \(\lambda\) модель навчається на одній частині даних, а якість оцінюється на даних, які не використовувалися для підгонки.
Для суто чисельної стабілізації можна орієнтуватися також на число обумовленості та допустиму зміну рішення. Проте надмірне зменшення \(\kappa\) ціною великого зміщення не є автоматично хорошим результатом.
Отже, вибір \(\lambda\) повинен бути пов’язаний із метою задачі: прогноз, стабільність параметрів, фізична правдоподібність або інший зовнішній критерій.
19. Зміщення та стабільність
Регуляризація навмисно додає зміщення: оцінка відходить від незашрафованого розв’язку. В обмін на це дисперсія або чутливість до шуму може зменшитися.
Цей компроміс часто називають компромісом між зміщенням і варіативністю. Для цього курсу достатньо розуміти практичний зміст: трохи гірша підгонка може дати надійніші параметри.
Регуляризація навмисно вводить зміщення. Навіть якщо звичайна оцінка без штрафу в середньому має правильний центр, регуляризована оцінка тягнеться до нуля або іншої заданої структури.
Ціна цього зміщення може бути виправданою, якщо значно зменшується чутливість до шуму. У прикладних задачах часто важливіше отримати стабільний прогноз, ніж нестійкі коефіцієнти, які різко змінюються після малої зміни даних.
Цей компроміс можна перевіряти експериментально: трохи змінити дані, повторно оцінити параметри й порівняти розкид розв’язків для різних \(\lambda\).
Так регуляризація стає частиною аналізу надійності й водночас змінює формулу цілі.
20. Границі при малому і великому параметрі регуляризації
При:
регуляризований розв’язок наближається до звичайного розв’язку найменших квадратів, якщо він добре визначений.
При:
штраф домінує, тому штрафовані параметри прямують до нуля.
Ці дві границі дають корисну перевірку програмної реалізації.
При \(\lambda\to0\) регуляризована задача наближається до початкових найменших квадратів. Якщо початковий розв’язок єдиний і стабільний, параметри плавно переходять до нього.
При \(\lambda\to\infty\) квадратичний штраф домінує. Для штрафу \(\lambda\|\theta\|_2^2\) параметри прямують до нуля, якщо всі компоненти штрафуються.
Ці граничні режими корисні як перевірка коду. Якщо при дуже малому \(\lambda\) результат сильно відрізняється від звичайних найменших квадратів, варто перевірити формулу. Якщо при дуже великому \(\lambda\) параметри не стискаються, можлива помилка у штрафі або порядку коефіцієнтів.
Програмна реалізація та перевірка
21. Одновимірний приклад у Python
# Імпортуємо NumPy для обчислень, розв’язання моделі та її перевірки.
import numpy as np


# Повертаємо аналітичний розв’язок регуляризованої скалярної задачі для заданого параметра.
def regularized_solution(lambda_value):
    return 4.0 / (1.0 + lambda_value)


# Перебираємо вибрані тестові значення, щоб порівняти поведінку методу на кількох випадках.
for lambda_value in [0.0, 1.0, 3.0]:
    theta = regularized_solution(
        lambda_value
    )

    # Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
    print(
        lambda_value,
        theta,
    )
Очікувані значення: 4, 2 і 1.
22. Регуляризовані найменші квадрати
# Імпортуємо NumPy для обчислень, розв’язання моделі та її перевірки.
import numpy as np


# Задаємо матрицю коефіцієнтів; порядок рядків і стовпців має збігатися з математичною моделлю.
A = np.array([
    [0.0, 1.0],
    [1.0, 1.0],
    [2.0, 1.0],
    [3.0, 1.0],
])

# Задаємо праві частини, запаси або спостереження у порядку, узгодженому з рядками матриці.
y = np.array([
    1.0,
    2.0,
    2.0,
    4.0,
])

# Задаємо параметр алгоритму, вплив якого далі перевіримо на результаті.
lambda_value = 1.0

# Виконуємо матричний або скалярний добуток, який прямо відповідає формулі математичної моделі.
system_matrix = (
    A.T @ A
    + lambda_value
    * np.eye(A.shape[1])
)

# Виконуємо матричний або скалярний добуток, який прямо відповідає формулі математичної моделі.
right_hand_side = A.T @ y

# Розв’язуємо лінійну систему напряму, без явного обчислення оберненої матриці.
parameters = np.linalg.solve(
    system_matrix,
    right_hand_side,
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print(parameters)
Для обчислення не потрібно формувати обернену матрицю. Систему:
розв’язують через np.linalg.solve для повнорозмірної додатно визначеної матриці або використовують спеціалізовані алгоритми.
У коді важливо, щоб одинична матриця мала той самий розмір, що й кількість параметрів. Якщо вільний член не штрафується, замість \(I\) використовується діагональна матриця з нулем у відповідній позиції.
Після розв’язання обчислюється стаціонарна нев’язка. Це незалежно підтверджує, що код розв’язав саме заявлену регуляризовану систему.
23. Перевірка стаціонарності
# Обчислюємо нев’язку стаціонарності безпосередньо з градієнтів і множників.
stationarity = (
    A.T @ (A @ parameters - y)
    + lambda_value * parameters
)

# Обчислюємо нев’язку стаціонарності безпосередньо з градієнтів і множників.
stationarity_residual = np.linalg.norm(
    stationarity
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print(stationarity_residual)
Нев’язка повинна бути близькою до машинного нуля.
Для регуляризованих найменших квадратів градієнт:
У чисельному розв’язку перевіряємо норму:
Мала нев’язка показує, що знайдені параметри узгоджуються з оптимізаційною умовою саме регуляризованої задачі.
Важливо не перевіряти старі нормальні рівняння \(A^Tr=0\). Після регуляризації вони загалом вже не виконуються, бо залишкова частина врівноважується штрафом:
Це хороший приклад того, як зміна моделі змінює правильний сертифікат.
24. Порівняння підгонки та норми параметрів
# Обчислюємо суму квадратів залишків як числову міру якості підгонки.
fit_residual = A @ parameters - y
fit_error = fit_residual @ fit_residual
parameter_norm = np.linalg.norm(
    parameters
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print("FIT_ERROR:", fit_error)
print("PARAMETER_NORM:", parameter_norm)
При зростанні \(\lambda\) норма параметрів зазвичай зменшується, а навчальна похибка підгонки — збільшується.
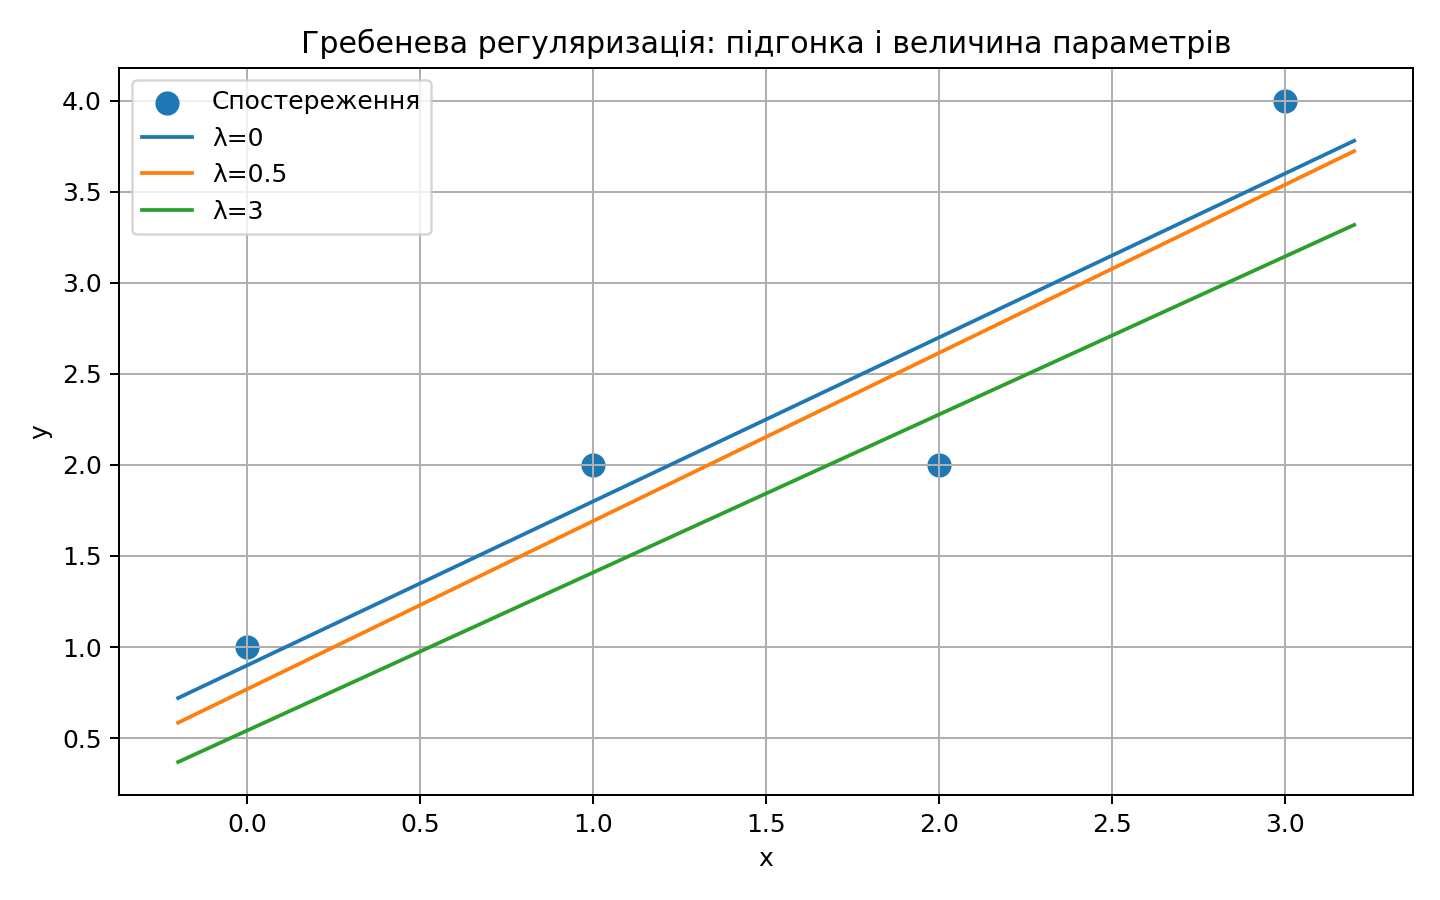
Корисний графік показує дві криві за \(\lambda\): похибку підгонки та норму параметрів. Зі зростанням штрафу норма зазвичай зменшується, а навчальна похибка зростає.
Точка, де невелике подальше зменшення норми вимагає великого погіршення підгонки, часто є предметно цікавою. У деяких задачах цю геометрію називають L-кривою.
Такий графік не визначає оптимальне \(\lambda\) автоматично, але робить компроміс видимим. Для прогнозної задачі остаточний вибір все одно краще перевіряти на окремих даних.
25. Число обумовленості
# Оцінюємо число обумовленості, щоб побачити чутливість задачі до малих числових похибок.
condition_before = np.linalg.cond(
    A.T @ A
)

# Оцінюємо число обумовленості, щоб побачити чутливість задачі до малих числових похибок.
condition_after = np.linalg.cond(
    system_matrix
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print(condition_before)
print(condition_after)
Поліпшення залежить від даних і \(\lambda\), тому його треба обчислювати, а не припускати.
26. Мінімальний блок результату
LAMBDA
PARAMETERS
FIT_ERROR
PARAMETER_NORM
CONDITION_NUMBER
STATIONARITY_RESIDUAL
Цей блок дозволяє побачити і якість підгонки, і силу регуляризації.
Для одного значення регуляризації результат можна подати так:
LAMBDA: 1.0
PARAMETERS: [...]
FIT_SSE: ...
PARAMETER_NORM: ...
REGULARIZATION_PENALTY: ...
TOTAL_OBJECTIVE: ...
STATIONARITY_RESIDUAL: ...
CONDITION_NUMBER: ...
FIT_SSE і REGULARIZATION_PENALTY потрібно зберігати окремо. Їхня сума з відповідним множником \(\lambda\) утворює повну ціль. Якщо показати лише TOTAL_OBJECTIVE, неможливо побачити, за рахунок чого змінився результат.
Для серії значень \(\lambda\) ці поля формують таблицю траєкторії регуляризації. Тоді можна порівнювати, як зменшується норма параметрів, як росте похибка підгонки та як змінюється число обумовленості.
Особливо корисно додати базовий рядок \(\lambda=0\). Він показує нерегуляризовану модель і робить ефект штрафу видимим.
Якщо використовується валідаційна похибка, її слід зберігати окремим полем. Вона не входить у навчальну ціль, але саме вона може визначати вибір \(\lambda\).
Інтерпретація, межі та підсумок
27. Типові помилки
Типова помилка. Значення \(\lambda\) обирають тільки за найменшою навчальною похибкою. Тоді регуляризація майже завжди програє незашрафованій моделі за самим навчальним критерієм.
Ще одна помилка — порівнювати \(\lambda\) між задачами без урахування масштабу ознак. Також не можна вважати зменшення числа обумовленості доказом правильності предметної моделі.
28. Коли регуляризація особливо корисна
Регуляризація корисна, коли:
- ознаки сильно корельовані;
- параметрів багато відносно кількості спостережень;
- матриця ознак погано обумовлена;
- потрібна стабільність параметрів;
- є предметне обґрунтування бажаної структури.
Регуляризація корисна при сильній кореляції ознак, великій кількості параметрів, малому наборі даних і високій чутливості оцінок до шуму. Вона також допомагає, коли предметно відомо, що надмірно великі коефіцієнти небажані.
Водночас регуляризація не виправляє неправильну модель даних, систематичну помилку вимірювання або пропущену важливу змінну. Вона стабілізує оцінювання в межах заданої структури.
Тому перед додаванням штрафу потрібно сформулювати, яку саме проблему він має вирішити. Це відрізняє обґрунтовану регуляризацію від випадкового налаштування коефіцієнта.
Ще один сигнал до регуляризації — нестійкий знак коефіцієнта між близькими вибірками. Якщо мала зміна кількох спостережень змінює параметр з великого додатного на великий від’ємний, модель має слабку ідентифікованість у цьому напрямі.
Регуляризація може зменшити амплітуду таких змін. Проте після стабілізації все одно потрібно перевірити, чи предметна інтерпретація параметрів узгоджується з даними та моделлю.
29. Що змінюється математично
Регуляризована задача має інший мінімізатор, ніж початкова. Тому не можна називати регуляризацію лише «чисельним прийомом». Вона змінює критерій оптимальності, додаючи нову перевагу до моделі.
Ця зміна може бути корисною, але повинна бути явною у звіті.
Інтерактивна самоперевірка лекції
Пройдіть 10 коротких питань. Після кожної відповіді ви побачите пояснення, а за потреби — підказку й повний розбір.
30. Підсумок
Регуляризація додає до початкової цілі явний штраф за небажану структуру параметрів. Для квадратичного штрафу скалярний приклад дає \(\theta^*(\lambda)=4/(1+\lambda)\), тому зі зростанням параметра регуляризації оцінка плавно стискається. Це показує головний компроміс між точністю підгонки та розміром параметрів.
У регуляризованих найменших квадратах система стаціонарності має вигляд \((A^TA+\lambda I)\theta=A^Ty\). Додавання \(\lambda I\) піднімає власні значення системної матриці й часто покращує її обумовленість. Водночас сильніший штраф збільшує відхилення від нерегуляризованого розв’язку, тому значення \(\lambda\) потрібно обирати за зовнішнім критерієм.
Масштаб ознак і рішення щодо штрафування вільного члена входять до математичної моделі. Для контрольованого експерименту фіксують дані, спосіб масштабування та правило штрафу, а потім змінюють лише \(\lambda\). Для кожного значення порівнюють похибку підгонки, норму параметрів, повну ціль, стаціонарну нев’язку та число обумовленості.
Після вибору параметра регуляризації всі перевірки повторюють для фінальної моделі. Такий порядок робить регуляризацію відтворюваним рішенням, а не прихованим налаштуванням алгоритму. Наступна тема переносить ідею компромісу на випадок кількох окремих критеріїв, де переваги вже потрібно показувати явно.
Після порівняння кількох значень параметра регуляризації важливо зафіксувати причину фінального вибору. У звіті варто показати, як змінилися похибка підгонки, норма параметрів і число обумовленості, а потім коротко пояснити прийнятий компроміс. Такий запис робить вибір параметра відтворюваним і зрозумілим для подальшої перевірки.