Лекція 16. Градієнтний спуск: алгоритм і критерії зупинки
Коротко про лекцію
Лекція перетворює напрям антиградієнта на повний ітераційний алгоритм. Ви розберете вибір початкової точки, роль кроку, журнал ітерацій та кілька критеріїв зупинки градієнтного спуску.
Практичний сенс. Один антиградієнтний крок показує локально корисний напрям. Повна оптимізація потребує повторювати такі кроки, контролювати прогрес і вчасно зупинятися. Градієнтний спуск, або градієнтний спуск, будує послідовність точок, які наближаються до стаціонарного розв’язку.
Постановка та базові поняття
1. Від одного кроку до алгоритму
У попередній лекції ми розглянули формулу:
Один крок може зменшити функцію, але оптимізаційний алгоритм повинен повторювати цей процес.
Індекс \(k\) означає номер ітерації.
Точка \(x_k\) є поточним наближенням до мінімізатора.
Градієнт \(\nabla f(x_k)\) визначає локальний напрям зростання.
Множник \(\alpha_k>0\) задає довжину кроку.
Мінус перед градієнтом переводить рух у напрям локального спадання.
1.1. Чому алгоритм називають градієнтним спуском
Слово спуск описує саму ідею: ми хочемо рухатися вниз за значенням цільової функції. Градієнт показує напрям найшвидшого локального зростання, тому крок у протилежний бік дає локальний рух униз.
Один такий крок ще не є повним методом. Після переходу градієнт змінюється, тому його потрібно обчислити знову. Повторення «обчислити градієнт → зробити крок → перевірити зупинку» утворює ітераційний процес.
Критерій зупинки потрібен, бо комп’ютер не може виконувати нескінченну кількість кроків. У цій лекції основним показником стаціонарності буде норма градієнта, а додатковими — зміна точки, зміна цілі та максимальна кількість ітерацій.
2. Наскрізна функція
Використаємо:
Градієнт:
Точний мінімізатор:
і:
Для демонстрації почнемо далеко від оптимуму:
3. Перша ітерація вручну
У стартовій точці:
Візьмемо:
Тоді:
Отримуємо:
Початкове значення:
Після кроку:
Функція суттєво зменшилася.
4. Що означає ітераційний процес
Кожна ітерація використовує поточну точку як новий локальний центр аналізу.
У точці \(x_k\) алгоритм обчислює градієнт і формує наступне наближення.
Після переходу до \(x_{k+1}\) старий градієнт більше не описує локальну поведінку в новій точці.
Тому градієнт потрібно обчислювати заново на кожній ітерації.
Це відрізняє градієнтний спуск від руху вздовж одного постійного вектора.
Для квадратичної функції напрям поступово повертається до мінімізатора.
Для нелінійної функції напрям може змінюватися значно сильніше.
У коді це означає, що виклик gradient(point) повинен знаходитися всередині ітераційного циклу.
Градієнтний спуск створює послідовність:
Кожна точка використовується для обчислення нового градієнта.
Тому напрям змінюється разом із положенням у просторі.
Алгоритм не рухається по одній прямій до мінімізатора.
На функціях із різною кривизною траєкторія може повертати, наближатися зигзагами або рухатися дуже повільно.
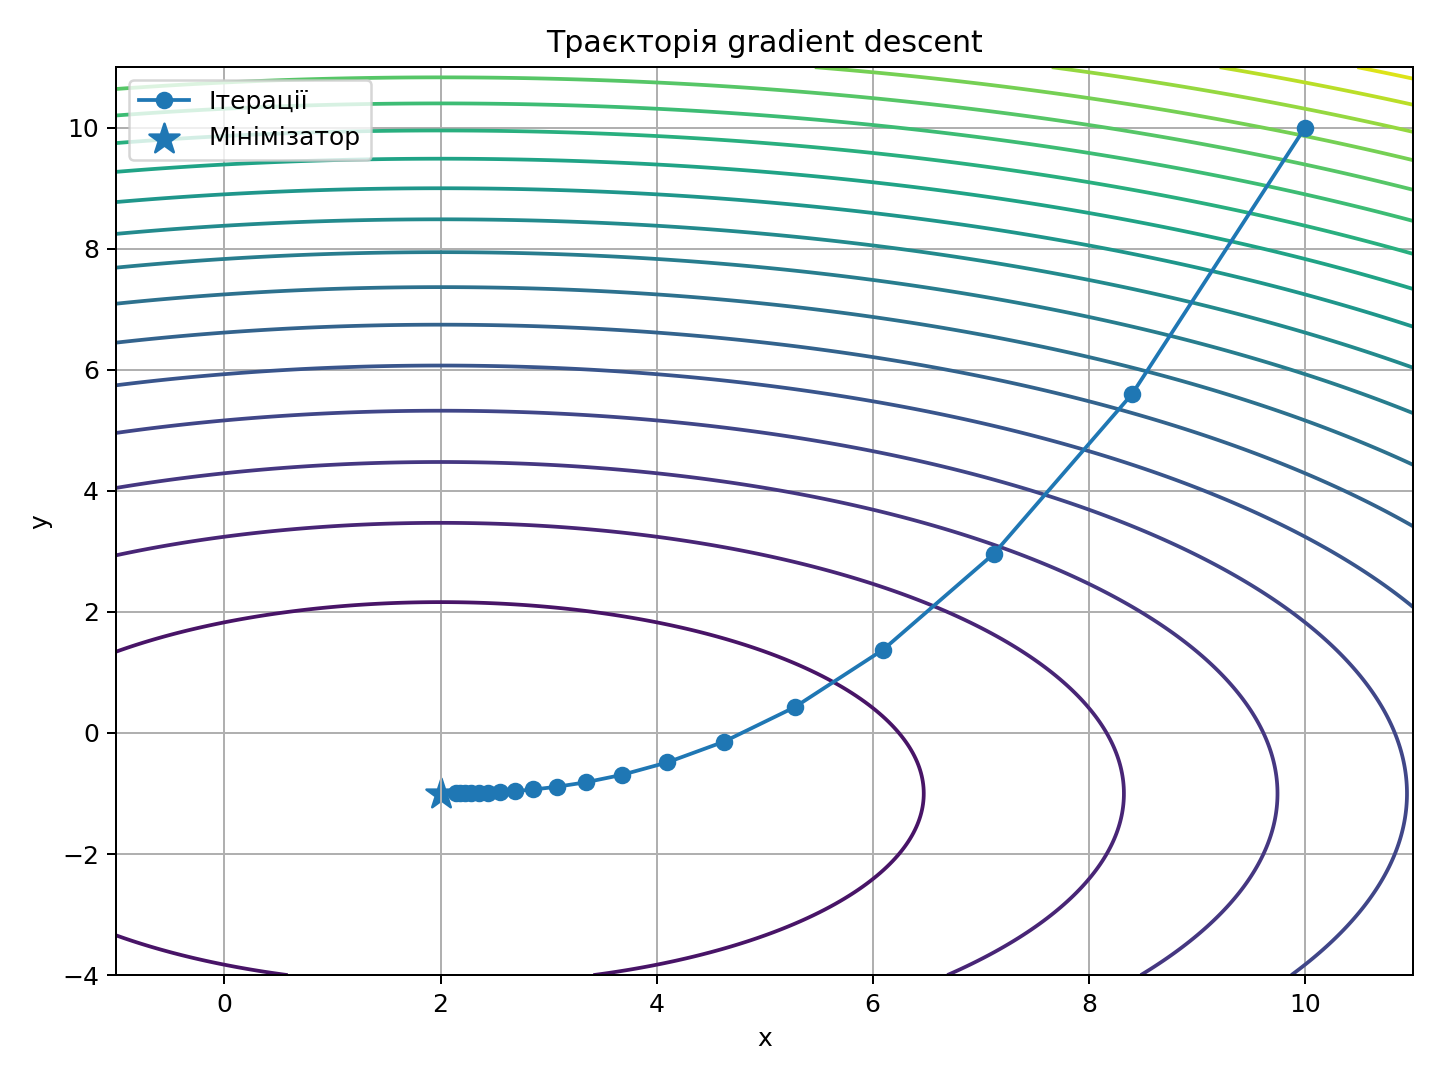
Рисунок показує поступове наближення від стартової точки до центру контурів.
Математична логіка
5. Чому антиградієнтний крок локально зменшує функцію
Для малого вектора кроку \(s\) маємо локальне наближення:
Візьмемо:
Тоді:
Якщо \(\alpha>0\) і градієнт ненульовий, цей доданок від’ємний.
Тому локальна лінійна модель прогнозує зменшення функції.
Цей висновок пояснює напрям кроку.
Вибір достатньо малого \(\alpha\) потрібен, щоб локальна модель залишалася придатною.
6. Нев’язка за нормою градієнта
Нев’язка має одиниці, пов’язані з функцією та змінними.
Якщо компоненти градієнта вимірюються в різних масштабах, звичайна евклідова норма може сильніше відображати одну координату.
Тому числовий допуск потрібно читати разом із масштабуванням задачі.
Для нашої навчальної функції обидві координати мають подібний числовий масштаб, тому норма добре працює без додаткових перетворень.
На практиці іноді використовують відносний критерій:
Такий запис враховує масштаб цільової функції.
Єдиного універсального числовий допуск для всіх моделей немає.
Критерій повинен бути достатньо строгим для математичної якості та достатньо реалістичним для чисельної точності даних.
Для внутрішнього гладкого мінімізатора без обмежень необхідна умова:
Тому природний нев’язка:
Якщо алгоритм наближається до стаціонарної точки, очікується зменшення \(r_g\).
Критерій може мати форму:
де \(\varepsilon_g\) — числовий допуск для норми градієнта.
7. Зміна цільової функції
Іноді корисно використовувати відносну зміну цілі.
Наприклад:
Знаменник не дозволяє критерію стати нестабільним, коли \(f(x_k)\) близьке до нуля.
Відносний нев’язка особливо корисний, якщо значення функції можуть мати дуже великий масштаб.
Наприклад, зміна на 1 гривню має різний зміст для цілі 10 гривень і для цілі 10 мільйонів гривень.
Тому абсолютний і відносний критерії відповідають на різні питання.
У навчальному коді достатньо абсолютного критерію, але в реальних чисельного розв’язувачах часто поєднуються кілька масштабованих умов.
Другий сигнал прогресу — зміна цілі:
Якщо \(\Delta f_k\) дуже мала, алгоритм майже не змінює значення функції.
Критерій:
може бути корисним, але сам по собі не доводить стаціонарність.
Алгоритм може мати надто малий крок і майже не рухатися далеко від мінімуму.
8. Зміна точки
Ще один критерій:
Перевірка:
показує, що ітерації стали близькими.
Як і для \(\Delta f_k\), малий крок може виникнути через поганий параметр \(\alpha\).
Тому надійний аудит використовує кілька сигналів разом.
9. Максимальна кількість ітерацій
Ліміт також потрібен для відтворюваності.
Якщо два студенти використовують однаковий алгоритм, але різні max_iterations, вони можуть отримати різну якість фінальної точки.
Тому параметр треба фіксувати в звіті.
Наприклад:
MAX_ITERATIONS: 1000
Якщо алгоритм завершився через ліміт, варто вивести останню норму градієнта.
Тоді можна оцінити, наскільки далеко результат від бажаного числовий допуск.
Якщо нев’язка зменшився майже до порогу, достатньо збільшити ліміт.
Якщо нев’язка майже не змінюється, проблема, ймовірно, пов’язана з кроком, масштабуванням або формою функції.
Чисельний алгоритм повинен мати захист від нескінченного циклу.
Вводять:
Наприклад:
max_iterations = 1000
Досягнення цієї межі не означає успішну збіжність.
Це окремий статус: алгоритм завершився через ліміт.
Після такого завершення потрібно дивитися на нев’язки і останню точку.
10. Що означає збіжність
Важливо розрізняти збіжність точок, значень функції та градієнта.
Може виконуватися:
навіть тоді, коли самі точки рухаються вздовж майже плоскої області.
Може зменшуватися \(\|\nabla f(x_k)\|\), але точка залишатися далеко від глобального мінімуму на неопуклій функції.
Тому чисельне слово «збіжність» завжди потребує уточнення: який саме критерій збігається.
У цій лекції головний критерій — стаціонарність за нормою градієнта.
Для відомої навчальної функції додатково доступна відстань до точного мінімізатор.
Послідовність \(x_k\) збігається до \(x^*\), якщо точки стають як завгодно близькими до \(x^*\) при великих \(k\).
Інтуїтивно:
Чисельна програма не виконує нескінченно багато кроків.
Тому замість математичної границі використовуються числовий допуск та ліміт ітерацій.
Практична збіжність означає, що обрані критерії досягли потрібного масштабу.
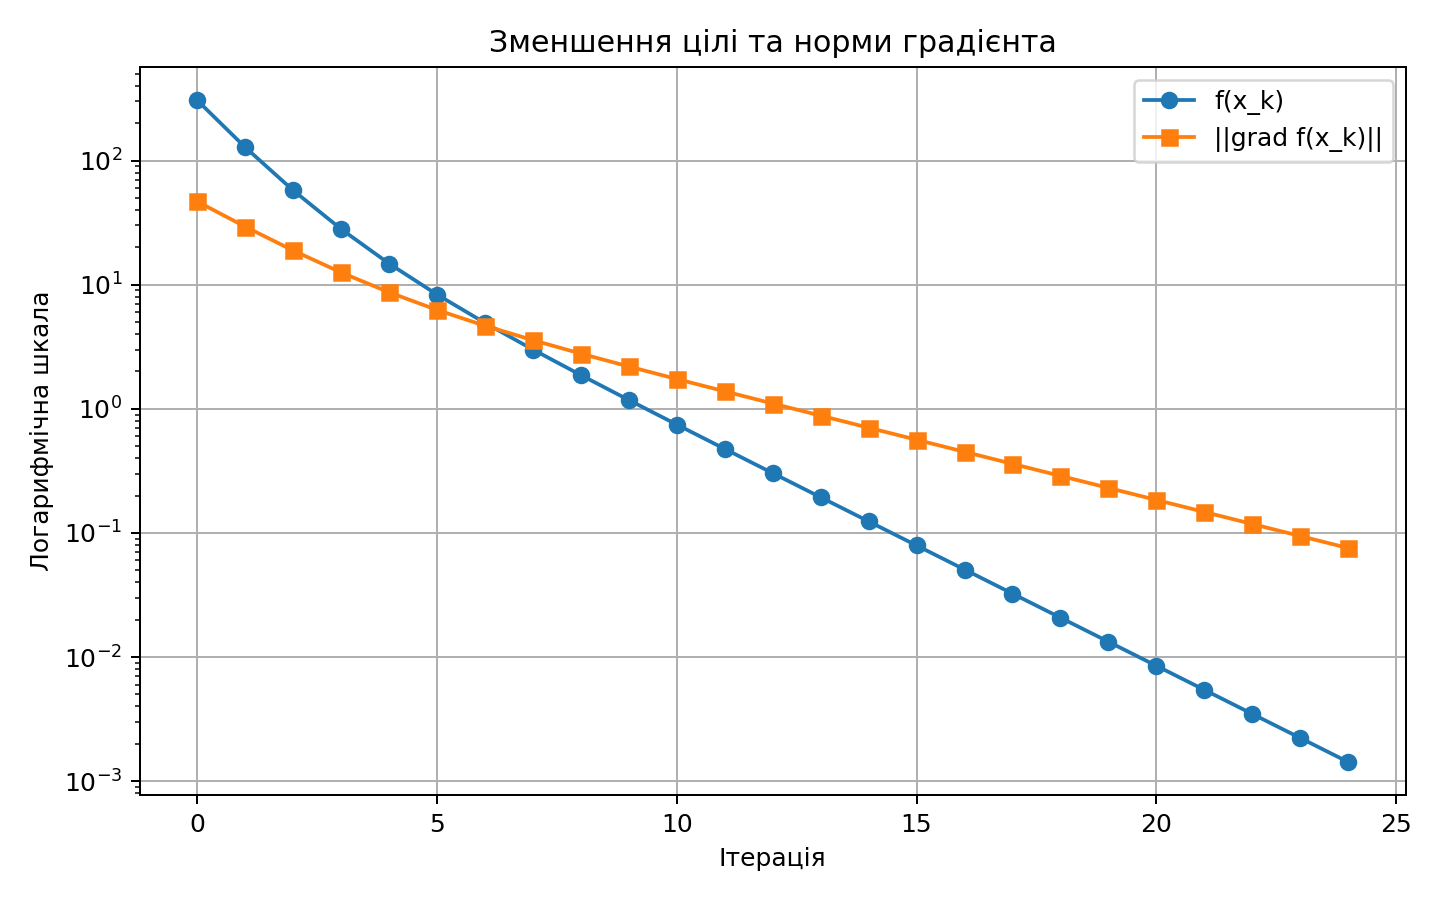
11. Зменшення цілі не обов’язково однакове на кожному кроці
На перших ітераціях алгоритм може швидко зменшувати функцію.
Ближче до мінімізатора кроки часто стають менш результативними.
Для квадратичної функції з фіксованим коректним кроком прогрес має регулярну структуру.
Для складної нелінійної функції швидкість може змінюватися.
Тому корисно дивитися на історію:
та:
Алгоритм і покроковий розбір
12. Базовий алгоритм
Ітераційний цикл корисно розділяти на три логічні фази.
Перша фаза — оцінювання поточного стану.
Тут обчислюються objective, gradient та нев’язки.
Друга фаза — прийняття рішення.
Алгоритм або завершується, або формує новий крок.
Третя фаза — оновлення точки та запис історії.
Таке розділення спрощує налагодження.
Якщо результат дивний, можна подивитися, на якому етапі виникла проблема: формула градієнта, критерій зупинки чи оновлення точки.
Для навчального коду ця структура важливіша за мінімальну кількість рядків.
Градієнтний спуск можна записати так:
- вибрати стартову точку \(x_0\);
- задати \(\alpha\), числовий допускs і
max_iterations; - обчислити \(f(x_k)\);
- обчислити \(\nabla f(x_k)\);
- перевірити норму градієнта;
- побудувати \(x_{k+1}\);
- перевірити зміну точки та цілі;
- перейти до наступної ітерації;
- завершити за критерієм або лімітом.
Такий порядок відділяє математичну дію від діагностики.
13. Друга ітерація вручну
Після першого кроку:
Градієнт:
Другий крок:
Отже:
Функція знову зменшується.
Цей розрахунок показує, що новий градієнт обчислюється в новій точці.
14. Норма градієнта на старті
У стартовій точці:
Отримуємо:
Це велике значення.
У мінімізаторі нев’язка дорівнює нулю.
Тому історія норми градієнта дає зручний числовий індикатор наближення.
15. Критерії краще комбінувати
Комбінація критеріїв допомагає уникнути помилкового завершення.
Наприклад, можна вимагати малий градієнт і водночас контролювати, що точка містить скінченні числа.
Перевірка:
# Перевіряємо, що всі координати точки є скінченними числами перед подальшими обчисленнями.
np.all(np.isfinite(point))
виявляє NaN та нескінченність.
Такі значення можуть виникнути після переповнення або невдалого кроку.
Інший корисний захист — перевірка скінченності цільової функції.
Якщо objective повернув inf, ітерацію не можна трактувати як звичайний крок.
Тому надійний алгоритм містить математичні критерії та базові чисельні захисти.
Практична умова завершення може вимагати малу норму градієнта.
Додатково можна перевірити малу зміну точки або цілі.
Наприклад, успіх фіксується, якщо:
а max_iterations ще не вичерпано.
Зміни \(\Delta x_k\) і \(\Delta f_k\) зберігаються як діагностичні числа.
Це дає змістовніший звіт, ніж одне повідомлення «готово».
16. Невдале завершення через малий крок
Припустімо, \(\alpha\) дуже мале.
Тоді:
може бути малим навіть при великому градієнті.
Тому критерій тільки за \(\Delta x_k\) може завершити алгоритм завчасно.
Математично точка ще не стаціонарна.
Цей приклад пояснює, чому нев’язка за градієнтом має окрему роль.
17. Невдале завершення через великий крок
Розбіжність часто видно ще до появи дуже великих чисел.
Ознаки проблеми:
- цільова функція зростає кілька ітерацій поспіль;
- норма градієнта збільшується;
- координати змінюють знак і зростають за модулем;
- з’являються
infабоNaN.
Алгоритм може завершитися раніше з статус на кшталт DIVERGED.
Такий статус корисніший за продовження циклу до технічного переповнення.
У навчальній реалізації достатньо порівнювати цільова функція та контролювати скінченність чисел.
У наступній лекції пошук довжини кроку дасть систематичний механізм зменшення небезпечного кроку.
Якщо \(\alpha\) завелике, функція може зростати або коливатися.
Тоді історія \(f(x_k)\) швидко показує проблему.
Алгоритм повинен або змінити крок, або завершитися з діагностичним статус.
У наступній лекції вибір \(\alpha\) розглядатиметься окремо через пошук довжини кроку і умови збіжності.
Програмна реалізація та перевірка
18. Зіставлення математики та Python
| Математика | Python | Зміст |
|---|---|---|
| \(x_k\) | point |
поточна точка |
| \(\nabla f(x_k)\) | current_gradient |
градієнт |
| \(\alpha\) | step_size |
довжина кроку |
| \(r_g\) | gradient_norm |
норма градієнта |
| \(\Delta f_k\) | objective_change |
зміна цілі |
| \(\Delta x_k\) | point_change |
зміна точки |
| \(k_{\max}\) | max_iterations |
захисний ліміт |
19. Навчальна реалізація
# Імпортуємо NumPy для обчислень, розв’язання моделі та її перевірки.
import numpy as np


# Описуємо цільову функцію тією самою формулою, що й у математичній постановці.
def objective(point):
    x = point[0]
    y = point[1]

    # Повертаємо обчислене значення, яке використає наступний крок алгоритму або перевірки.
    return (
        (x - 2.0) ** 2
        + 2.0 * (y + 1.0) ** 2
    )


# Описуємо градієнт у фіксованому порядку координат, щоб код відповідав математичному вектору.
def gradient(point):
    x = point[0]
    y = point[1]

    # Повертаємо обчислене значення, яке використає наступний крок алгоритму або перевірки.
    return np.array([
        2.0 * (x - 2.0),
        4.0 * (y + 1.0),
    ])


# Задаємо конкретну точку, план або множники, для яких далі виконаємо математичну перевірку.
point = np.array([
    10.0,
    10.0,
])

# Задаємо параметр алгоритму, вплив якого далі перевіримо на результаті.
step_size = 0.1
gradient_tolerance = 1e-6
max_iterations = 1000

# Виконуємо крок градієнтного спуску та оновлюємо метрики збіжності.
status = "MAX_ITERATIONS"

# Обчислюємо норму діагностичного вектора; мале значення використовуємо як критерій перевірки.
for iteration in range(max_iterations):
    current_gradient = gradient(point)
    gradient_norm = np.linalg.norm(
        current_gradient
    )

    # Перевіряємо умову алгоритму перед вибором наступної гілки обчислень.
    if gradient_norm <= gradient_tolerance:
        status = "CONVERGED"
        break

    # Виконуємо крок градієнтного спуску та оновлюємо метрики збіжності.
    point = (
        point
        - step_size * current_gradient
    )

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print("STATUS:", status)
print("X:", point)
print("OBJECTIVE:", objective(point))
print("GRAD_NORM:", np.linalg.norm(gradient(point)))
print("ITERATIONS:", iteration)
Код використовує норму градієнта як головний критерій.
20. Очікуваний результат
Для перевірки можна також вивести перші дві ітерації.
Очікувано:
ITERATION 0
X: [10. 10.]
F: 306.0

ITERATION 1
X: [8.4 5.6]
F: 128.08
Пізніші точки поступово наближаються до \((2,-1)\).
Коли норма градієнта стане меншою за \(10^{-6}\), алгоритм завершиться.
Кількість ітерацій залежить від довжина кроку та числовий допуск.
Якщо змінити \(\alpha\), фінальний математичний ціль не зміниться, але траєкторія й число ітерацій зміняться.
Очікується точка, дуже близька до:
[ 2. -1.]
Значення цілі повинно бути близьким до нуля.
GRAD_NORM повинен бути меншим за заданий числовий допуск.
Статус має бути CONVERGED, якщо ліміт ітерацій достатній.
Останні десяткові цифри залежать від з рухомою комою обчислень.
21. Перевірка результату
Еталонна перевірка корисна для навчання, бо точний мінімізатор відомий.
Нехай алгоритм повернув:
Тоді відстань до точного розв’язку:
буде дуже малою.
Окремо перевіряємо нев’язка градієнта.
Якщо обидва нев’язки малі, чисельний результат узгоджується з відомою теорією.
У реальній задачі \(x^*\) невідомий, тому \(r_x\) недоступний.
Тоді головними залишаються математичні умови, історія значень цільової функції та чисельна стабільність.
Для отриманої точки \(\hat{x}\) перевіряємо:
та:
Для навчальної функції відомий точний мінімізатор, тому можна додати:
Малий \(r_x\) є додатковою еталонною перевіркою.
22. Історія ітерацій
Історію зручно зберігати як список словників або рядків таблиці.
Наприклад:
# Обчислюємо норму діагностичного вектора; мале значення використовуємо як критерій перевірки.
history.append({
    "iteration": iteration,
    "objective": current_value,
    "gradient_norm": gradient_norm,
})
Після завершення можна побудувати графік збіжності.
Логарифмічна вертикальна шкала добре показує зменшення нев’язка на кілька порядків.
Якщо крива перестала спадати далеко від числовий допуск, це сигнал плато.
Якщо крива йде вгору, алгоритм нестабільний.
Тому графік збіжності є діагностичним інструментом, а не декоративним елементом.
Для діагностики корисно зберігати:
iteration
objective
gradient_norm
point_change
Історія показує, чи алгоритм стабільно рухався до стаціонарності.
Вона допомагає відрізнити повільну збіжність від чисельної проблеми.
У студентській роботі достатньо навести кілька перших і останню ітерацію.
Інтерпретація, межі та підсумок
23. Типові помилки
Ще одна поширена помилка — змінювати числовий допуск під час експерименту без фіксації цього факту.
Результати з різними числовий допускs не можна порівнювати тільки за кількістю ітерацій.
Більш строгий числовий допуск природно потребує більше кроків.
Також студенти іноді округлюють точку всередині циклу.
Наприклад, примусове округлення координат до двох знаків може зупинити прогрес і створити штучну стаціонарність.
Внутрішні обчислення слід виконувати з повною доступною точністю.
Округлення застосовується тільки для представлення фінального результату.
Типова помилка. Завершення за малою зміною точки приймають за доказ збіжності. Дуже малий довжина кроку також створює малі кроки.
Друга помилка — відсутній max_iterations.
Третя — градієнт обчислюється один раз і не оновлюється після переходу.
Четверта — статус повідомляє тільки «успішне завершення» без числового нев’язка.
П’ята — числовий допуск вибирається без урахування масштабу задачі.
24. Що означає хороший критерій зупинки
У складнішій програмі статус можна робити більш конкретним.
Наприклад:
CONVERGED_GRADIENT
MAX_ITERATIONS
NON_FINITE_OBJECTIVE
DIVERGED
Тоді причина завершення стає частиною результату.
Такий контракт корисний для автоматичної перевірки.
Він також допомагає студенту побачити, що завершення циклу і математична збіжність є різними подіями.
Добрий чисельний розв’язувач не приховує причину зупинки.
Він повертає її разом із числовими нев’язки.
Критерій має бути пов’язаний із математичною умовою оптимальності.
Для внутрішньої гладкої безумовної задачі такою умовою є малий градієнт.
Додаткові критерії допомагають діагностувати поведінку алгоритму.
Ліміт ітерацій захищає програму від нескінченного циклу.
У звіті потрібно назвати причину завершення.
25. Локальність методу
Стартова точка може суттєво впливати на результат.
На функції з кількома локальними мінімумами різні \(x_0\) можуть привести до різних точок.
Тому в неопуклих задачах іноді запускають алгоритм із кількох стартів.
Після цього порівнюють фінальні допустимі результати.
Такий багаторазовий запуск із різних початкових точок підхід не гарантує глобальність, але зменшує ризик залежності від одного невдалого старту.
Для нашої квадратичної функції проблема відсутня: є один глобальний мінімізатор.
Градієнтний спуск використовує локальну інформацію.
На неопуклій функції різні стартові точки можуть привести до різних стаціонарних точок.
Тому один успішний запуск не є доказом глобального оптимуму для довільної задачі.
Для опуклих функцій ситуація значно краща, і курс повернеться до цього в лекціях про опуклість.
26. Практичний звіт
Корисно також додати коротку інтерпретацію статус.
Наприклад:
STATUS: CONVERGED
GRAD_NORM: 8.2e-7
TOLERANCE: 1e-6
Цей блок одразу пояснює, чому завершення вважається успішним.
Якщо статус дорівнює MAX_ITERATIONS, поруч слід показати останній нев’язка.
Тоді викладач або автоматична система може оцінити якість без повторного запуску всього коду.
Машиночитаний результат і математичний звіт повинні описувати ті самі величини.
Мінімальний чисельний звіт містить:
- стартову точку;
- довжина кроку;
- числовий допуск;
- максимальну кількість ітерацій;
- статус;
- фінальну точку;
- цільова функція;
- норма градієнта;
- кількість ітерацій.
Цей формат робить результат відтворюваним.
26.1. Як порівнювати два запуски
Порівняння має використовувати однакові стартові умови.
Якщо один запуск починається ближче до мінімізатор, менша кількість ітерацій ще не доводить кращий алгоритм.
Також потрібно фіксувати однаковий числовий допуск.
Для коректного експерименту зберігайте:
START_X
STEP_SIZE
TOLERANCE
MAX_ITERATIONS
Після цього можна порівнювати ITERATIONS, OBJECTIVE та GRAD_NORM.
Такий підхід формує відтворюваний чисельний експеримент.
26.2. Контроль помилки в реалізації
Якщо цільова функція зменшується, але норма градієнта поводиться дивно, потрібно перевірити похідна.
Якщо градієнт правильний, але точка оновлюється в напрямі зростання, потрібно перевірити знак у оновлення.
Якщо всі числа правильні, але статус не змінюється, проблема може бути у зупинки умова.
Тому налагодження градієнтного спуску варто проводити поетапно:
- перевірити цільова функція;
- перевірити градієнт;
- перевірити один ручний крок;
- перевірити цикл;
- перевірити критерії зупинки.
Це швидше за спробу читати весь код одночасно.
26.3. Вплив стартової точки
Для опуклий квадратична функція різні стартові точки ведуть до одного мінімізатор за коректного довжина кроку.
Проте кількість ітерацій може відрізнятися.
Старт далеко від центру має більший початковий норма градієнта.
Це означає довший шлях до заданого числовий допуск.
У звіті стартова точка повинна бути частиною експеримент множинаup.
26.4. Перевірка одного кроку перед циклом
Перед запуском for корисно вручну обчислити перший крок.
Для нашої задачі очікується:
Якщо програма дає іншу точку, цикл не потрібно запускати далі.
Спочатку слід виправити градієнт або формула оновлення.
26.5. Остаточна перевірка алгоритму
Перед завершенням переконайтеся, що можете відтворити перші дві ітерації вручну, пояснити значення норма градієнта і назвати причину кожного можливого статус.
Градієнтний спуск вважається зрозумілим тільки тоді, коли формула кроку, критерії зупинки та чисельний діагностика утворюють одну послідовну систему.
26.6. Практична самоперевірка
Потрібно вміти вручну виконати один градієнтний крок, пояснити роль \(\alpha\), обчислити норму градієнта й прочитати статус завершення.
Також потрібно розуміти, чому мала зміна точки сама по собі не гарантує стаціонарність.
Цей набір умінь достатній для переходу до адаптивного вибору довжина кроку.
26.7. Контрольна думка
Градієнтний спуск є коректно описаним тільки тоді, коли в матеріалі присутні старт, формула оновлення, критерій зупинки і чисельна перевірка. Відсутність будь-якого з цих елементів робить опис алгоритму неповним.
26.8. Практична інтерпретація
У прикладній задачі ітерація означає послідовне уточнення рішення. Студент повинен бачити зв’язок між зменшенням цільова функція, зменшенням норма градієнта і фактичним наближенням параметрів. Ці три величини разом дають зрозумілу картину прогресу.
Інтерактивна самоперевірка лекції
Пройдіть 10 коротких питань. Після кожної відповіді ви побачите пояснення, а за потреби — підказку й повний розбір.
27. Підсумок
Градієнтний спуск перетворює один антиградієнтний крок на послідовність ітерацій \(x_0,x_1,x_2,\ldots\). На кожній ітерації градієнт обчислюється заново, бо локальна геометрія функції змінюється разом із точкою. Довжина кроку визначає масштаб переходу, а історія значень цілі та градієнта показує, як поводиться процес.
Критерій зупинки повинен описувати математичний стан алгоритму. Мала норма градієнта підтримує висновок про стаціонарність, мала зміна точки показує майже відсутній рух, а ліміт ітерацій захищає від нескінченного циклу. Корисно зберігати причину завершення, кількість ітерацій, фінальну точку, ціль і норму градієнта.
Збіжність оцінюють за сукупністю метрик, а не за одним числом. Навіть правильний напрям може давати повільний або нестабільний процес через невдалу довжину кроку. Наступна лекція детально розглядає вибір цього параметра та умови прийняття кроку.