Лекція 30. Чисельна надійність та аудит оптимізаційного розв’язку
Коротко про лекцію
Завершальна лекція збирає чисельний аудит оптимізаційного розв’язку в єдину процедуру. Ви навчитеся перевіряти статус, допуски, нев’язки, обмеження, цільову функцію та відтворюваність результату перед практичним використанням.
Практичний сенс. Правильна математична формула ще не гарантує надійного чисельного результату. Дані мають скінченну точність, алгоритми зупиняються за допусками, а погано обумовлена задача може сильно підсилити малу похибку. Тому завершення курсу присвячене системному аудиту: модель → результат → нев’язки → чутливість → інтерпретація.
Постановка та базові поняття
1. Чому правильна формула ще не гарантує правильне число
Комп’ютер зберігає більшість дійсних чисел наближено. Навіть прості операції можуть накопичувати похибку округлення. Крім того, чисельний метод може зупинитися до точного виконання математичних умов.
Тому результат треба оцінювати системою незалежних перевірок. Кількість десяткових знаків сама по собі не є показником надійності.
Чисельна оптимізація поєднує математичну модель, алгоритм і арифметику комп’ютера. Помилка може виникнути на кожному рівні. Формула може бути правильною, але дані переплутані. Алгоритм може завершитися коректно, але для іншої знакової домовленості. Обчислення можуть втрачати точність через погане масштабування.
Тому фінальний результат потрібно розглядати як твердження, яке має пройти аудит. Запитання «яке число повернула бібліотека?» є лише одним етапом. Далі потрібно з’ясувати, чи виконує точка початкові обмеження, чи узгоджується значення цілі, чи малі нев’язки оптимальності та чи не є задача надмірно чутливою.
Ця лекція збирає перевірки з усього курсу в єдину послідовність.
1.1. Чим відрізняються похибка, нев’язка та число обумовленості
Похибка порівнює обчислений результат із правильним значенням, якщо воно відоме.
Нев’язка відповідає на інше запитання: наскільки знайдений результат виконує вихідне рівняння, обмеження або умову стаціонарності після підстановки.
Число обумовленості показує, наскільки сильно мала зміна вхідних даних може змінити розв’язок. Тому мала нев’язка не завжди означає малу похибку в погано обумовленій задачі.
2. Чисельна надійність
Чисельно надійний результат має кілька рівнів доказів:
- математична модель правильна;
- дані та одиниці узгоджені;
- алгоритм завершився зрозумілим статусом;
- точка допустима;
- умови оптимальності виконані в межах допуску;
- задача не надто чутлива або ця чутливість врахована;
- результат можна відтворити.
3. Арифметика з рухомою комою
Числа типу float64 мають обмежену кількість значущих бітів. Наприклад, десяткове число 0.1 не має точного скінченного двійкового подання.
Тому перевірка:
# Демонструємо, що двійкова арифметика з рухомою комою може порушити очікуване десяткове порівняння.
0.1 + 0.2 == 0.3
може дати False.
Це властивість двійкового подання чисел у машинній арифметиці Python.
Комп’ютер зберігає більшість дійсних чисел скінченною кількістю бітів. Значення на кшталт \(0.1\) не мають точного двійкового представлення, тому після операцій з’являються малі похибки округлення.
Через це перевірка a == b для результатів чисельної оптимізації часто є невдалою ідеєю. Математична рівність замінюється перевіркою з допуском.
Проблема стає серйознішою, коли віднімаються близькі великі числа або поєднуються дуже різні масштаби. Тоді частина значущих цифр може втрачатися.
Числовий допуск не виправляє довільну похибку. Він лише визначає межу, в якій відхилення вважається прийнятним для конкретного масштабу та методу.
4. Абсолютний числовий допуск
Проста перевірка:
добре працює, коли всі величини мають подібний масштаб.
Наприклад, різниця \(10^{-8}\) є малою порівняно з одиницею, але може бути великою порівняно з \(10^{-10}\).
5. Відносний числовий допуск
Для великих значень зручно враховувати масштаб:
Так перевірка має абсолютну частину біля нуля та відносну частину для великих чисел.
Абсолютний допуск добре працює для величин одного масштабу. Якщо порівнюємо числа порядку \(10^9\), різниця \(0.01\) може бути відносно мізерною. Для чисел порядку \(10^{-8}\) та сама різниця величезна.
Тому часто використовують комбіноване правило:
Абсолютна частина захищає порівняння поблизу нуля, а відносна масштабує допустиму різницю для великих значень.
У перевіряльнику краще давати допускам імена за змістом: FEASIBILITY_TOL, GRADIENT_TOL, OBJECTIVE_TOL. Різні математичні умови можуть потребувати різних порогів.
6. Похибка та нев’язка на простому рівнянні
Нехай треба розв’язати:
Для знайденого \(\widehat x\) нев’язка:
і можна оцінити:
Якщо точний \(x^*\) відомий, можна також обчислити пряму похибку:
У реальній задачі точний \(x^*\) часто невідомий, тому нев’язка практично доступніша.
Математична логіка
7. Число обумовленості
Для невиродженої матриці у вибраній нормі:
Для симетричної додатно визначеної матриці в евклідовій нормі:
Велике число означає сильну потенційну чутливість.
Число обумовленості описує чутливість задачі до малих змін даних. Воно є властивістю математичної постановки, а не конкретного чисельного алгоритму.
Для лінійної системи \(Ax=b\) велике \(\kappa(A)\) означає, що невелике відносне збурення \(A\) або \(b\) може спричинити значно більшу відносну зміну розв’язку. Для симетричної додатно визначеної матриці відношення найбільшого та найменшого власних значень дає зрозумілий геометричний образ витягнутих рівнів.
Важливо не трактувати число обумовленості як абсолютний вирок. Його значення потрібно читати разом із точністю даних, масштабом і вимогами задачі. Проте різке зростання \(\kappa\) є сигналом для масштабування, регуляризації або перегляду моделі.
8. Наскрізний погано обумовлений приклад
Розглянемо:
Матриця Гессе:
Число обумовленості:
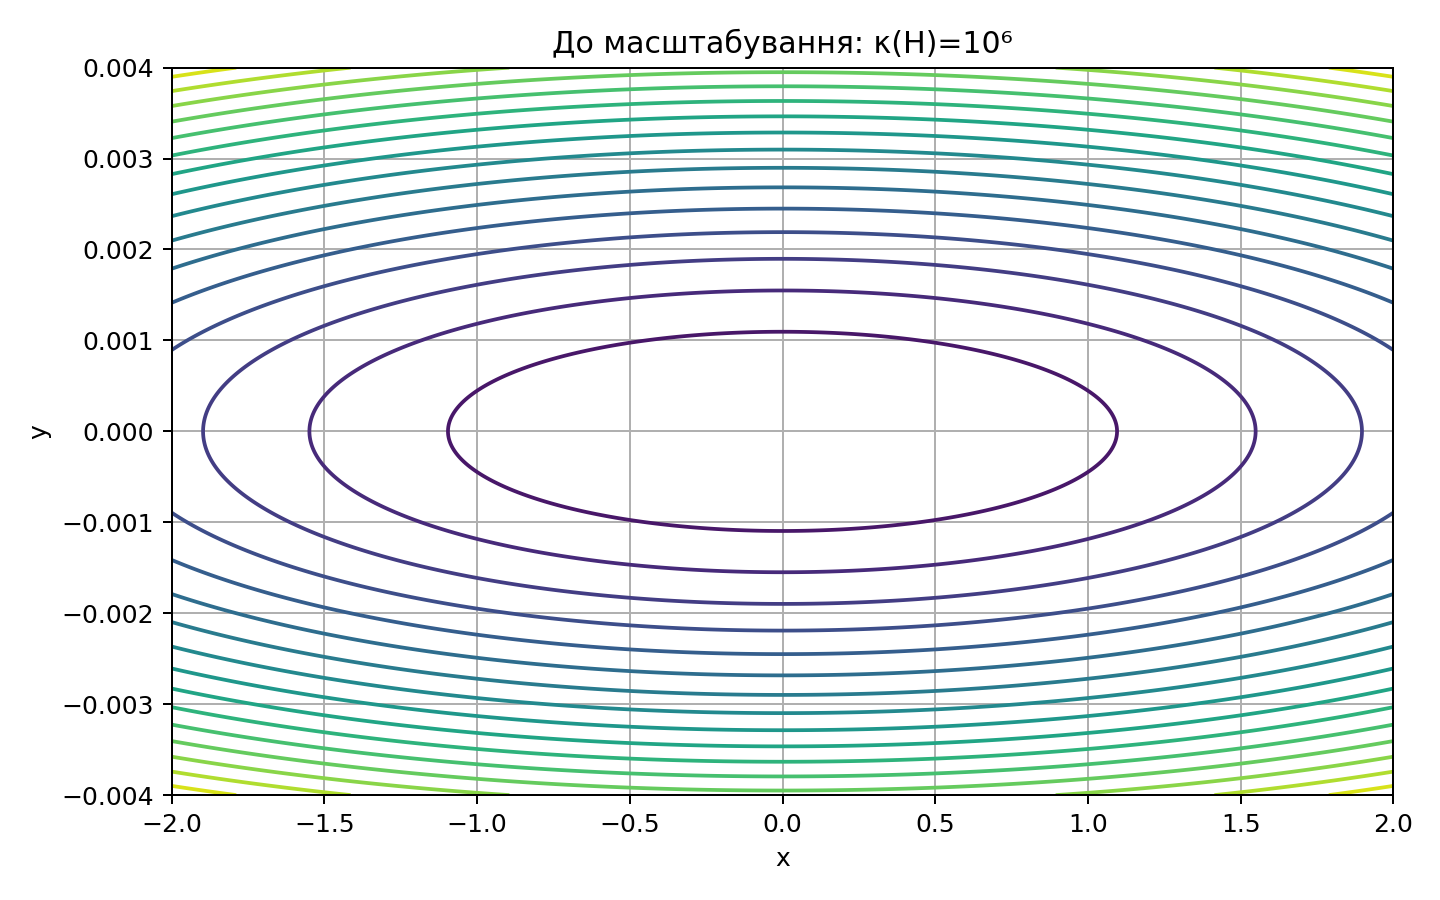
Лінії рівня дуже витягнуті. Градієнтний метод бачить зовсім різні масштаби кривизни за координатами.
Розглянемо:
Матриця Гессе:
має власні значення 1 і \(10^6\). Тому:
Рівні функції є дуже витягнутими еліпсами. Уздовж \(y\) ціль змінюється у мільйон разів швидше, ніж уздовж \(x\).
Градієнтний метод із одним кроком змушений бути достатньо обережним для крутого напряму \(y\). Через це прогрес уздовж \(x\) може бути повільним. Цей приклад показує, як геометрія безпосередньо переходить у поведінку алгоритму.
9. Масштабування координати
Введемо нову змінну:
Тоді:
Після підстановки:
Матриця Гессе стає одиничною, а число обумовленості — 1.
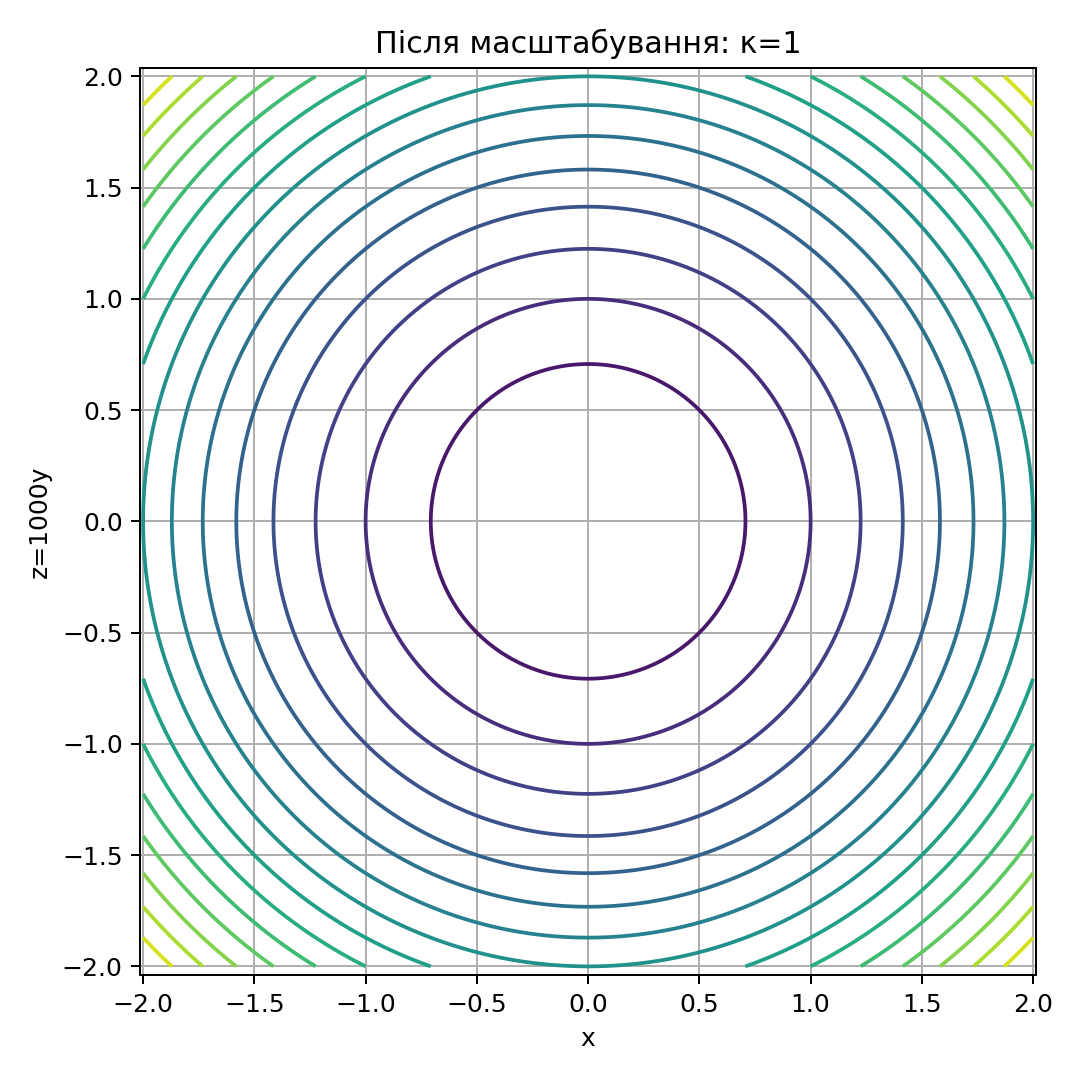
Введемо нову змінну:
тоді:
Після підстановки:
Матриця Гессе в нових координатах стає одиничною, а число обумовленості дорівнює 1.
Математична фізична точка не змінилася — змінився спосіб її координатного опису. Алгоритм тепер бачить однакові масштаби кривизни.
Після розв’язання результат потрібно повернути до початкових одиниць через \(y=z/1000\). Тому параметри масштабування мають бути частиною відтворюваного опису.
10. Що саме змінилося
Ми не змінили фізичний розв’язок. Ми лише виразили другу координату в іншому масштабі. Після обчислення значення \(z\) треба повернути до початкової змінної \(y\).
Масштабування є коректним, якщо між старими та новими координатами існує однозначне перетворення і предметний зміст зберігається.
11. Масштабування обмежень
Подібна проблема виникає в рядках обмежень. Одне рівняння може містити коефіцієнти порядку \(10^6\), інше — \(10^{-4}\). Помноження рівняння на ненульову константу не змінює його множину розв’язків, але змінює числовий масштаб коефіцієнтів.
Тому іноді корисно нормувати рядки, не змінюючи їхнього змісту.
12. Чому мала нев’язка не завжди означає точний розв’язок
У добре обумовленій задачі мала нев’язка зазвичай узгоджується з малою похибкою. У погано обумовленій задачі невелика зміна правої частини може викликати велику зміну розв’язку.
Тому два показники треба читати разом: нев’язка показує виконання рівнянь, число обумовленості — чутливість розв’язку.
Для системи \(Ax=b\) нев’язка:
показує, наскільки добре кандидат виконує рівняння. Пряма похибка:
показує відстань до точного розв’язку. Це різні величини.
У добре обумовленій задачі мала нев’язка зазвичай підтримує висновок про малу похибку. У погано обумовленій задачі матриця може сильно підсилювати певні напрями похибки, тому малий \(r\) співіснує з помітним \(e\).
Через це перевірка чисельного результату повинна містити і нев’язки, і показники обумовленості. Нев’язка відповідає на питання «чи виконується рівняння?», а обумовленість — «наскільки цей факт контролює точність самого розв’язку?».
13. Обернена похибка
Ще одне корисне запитання: для яких трохи змінених даних обчислений результат був би точним? Величину такого збурення називають оберненою похибкою.
Чисельно стійкий алгоритм часто можна тлумачити як такий, що точно розв’язує близьку задачу. Якщо сама задача добре обумовлена, це дає малу пряму похибку. Якщо задача погано обумовлена, навіть дуже стійкий алгоритм не може усунути чутливість, закладену в даних.
14. Критерій зупинки як частина методу
Чисельний метод повинен мати явний критерій зупинки. Потрібно назвати конкретну нев’язку та конкретний допуск.
Для задачі без обмежень це може бути:
Для рівностей — нев’язка \(Ax-b\). Для KKT — окремі нев’язки допустимості, стаціонарності та комплементарності.
15. Чому одного критерію зупинки недостатньо
Мала зміна точки може виникнути через надто малий крок. Мала зміна цільової функції може виникнути на пласкій ділянці далеко від стаціонарності. Досягнення максимальної кількості ітерацій взагалі не є доказом оптимальності.
Тому надійний алгоритм поєднує кілька критеріїв та повертає причину завершення.
Алгоритм і покроковий розбір
16. Аудит починається до запуску розв’язувача
Перед обчисленням треба перевірити:
- порядок змінних;
- одиниці вимірювання;
- знаки обмежень;
- розміри масивів;
- скінченність вхідних значень;
- структурні припущення методу;
- масштаб коефіцієнтів.
Багато «чисельних» проблем насправді виникають через помилку моделі або даних.
Перший етап аудиту стосується даних і моделі. Потрібно перевірити розміри масивів, порядок змінних, одиниці вимірювання, знаки цілі та обмежень, скінченність усіх чисел і відсутність очевидних суперечностей.
Далі корисно підставити одну просту тестову точку, значення якої можна порахувати вручну. Це перевіряє відповідність формули та коду до запуску складного алгоритму.
Для матричних моделей окремо перевіряються симетрія, ранг, власні значення або інші структурні властивості. Якщо задача декларується опуклою, це твердження повинно мати математичну основу.
Такий передстартовий аудит часто ловить помилку дешевше, ніж аналіз дивної поведінки чисельного методу.
17. Статус розв’язувача
Статус пояснює, чому алгоритм завершився. Можливі змістовні категорії:
OPTIMAL
INFEASIBLE
UNBOUNDED
MAX_ITERATIONS
NUMERICAL_FAILURE
Конкретні назви залежать від бібліотеки. У власному звіті їх можна приводити до єдиної внутрішньої класифікації.
Статус пояснює причину завершення алгоритму. Типові стани можуть означати успіх, досягнення ліміту ітерацій, недопустимість, необмеженість або чисельну проблему.
Статус потрібно читати до використання значень змінних. Якщо алгоритм завершився через ліміт ітерацій, повернена точка може бути корисним наближенням, але її не слід автоматично називати оптимальною.
Навіть статус успіху потребує незалежної перевірки. Бібліотека перевіряє ту модель, яку отримала. Вона не знає, чи правильно користувач переніс предметну постановку.
Тому статус є першим полем результату, а не фінальним доказом.
18. Перевірка допустимості
Для нерівностей \(g_i(x)\le0\):
Для рівностей:
Для меж змінних перевіряють нижні та верхні порушення окремо або включають їх у загальний список нерівностей.
19. Перевірка стаціонарності
Для задачі без обмежень:
Для задачі з рівностями використовують градієнт функції Лагранжа. Для KKT додають активні нерівності та їхні множники.
Отже, слово «стаціонарність» має одну ідею, але конкретна формула залежить від класу задачі.
20. Перевірка найменших квадратів
Для методу найменших квадратів корисно зберігати:
- вектор залишків;
- SSE або RMSE;
- \(\|A^Tr\|\);
- ранг матриці;
- сингулярні значення;
- число обумовленості.
Мала SSE не гарантує стабільні параметри при майже залежних стовпцях.
21. Перевірка KKT
Для задачі з обмеженнями зберігають окремо:
- пряму нев’язку;
- двоїсту нев’язку;
- нев’язку стаціонарності;
- нев’язку комплементарності.
Їхній максимум зручний для автоматичного рішення «пройдено/не пройдено», але окремі величини потрібні для діагностики.
Для задачі з гладкими нерівностями аудит збирає чотири групи нев’язок: пряму, двоїсту, стаціонарну та комплементарну.
Корисний агрегат:
показує найгіршу складову. Якщо задача опукла й умови регулярності виконані, малий KKT-залишок разом зі структурним аналізом підтримує сильний висновок про глобальний оптимум.
Для неопуклої задачі KKT перевіряє лише локальні необхідні умови. Тому поле KKT_RESIDUAL повинно супроводжуватися інформацією про клас задачі.
22. Повторне обчислення цільової функції
Не варто покладатися лише на поле результату чисельної бібліотеки. Потрібно повторно обчислити цільову функцію за початковою математичною формулою та повернутими координатами.
Це допомагає знайти пропущену сталу, неправильний знак або переплутаний порядок коефіцієнтів.
Чисельний розв’язувач може повертати значення цілі окремим полем. Перевіряльник повинен повторно обчислити його з початкової математичної формули.
Для задачі максимізації, яку бібліотека внутрішньо перетворює на мінімізацію, це особливо важливо. Помилка знака може дати правильний вектор змінних у простому прикладі, але неправильне повідомлене значення.
Порівнюємо:
з окремим допуском цілі.
Також потрібно враховувати сталі доданки, які не впливають на мінімізатор, але впливають на числове значення цільової функції.
23. Чутливість до стартової точки
У неопуклих задачах різні початкові точки можуть приводити до різних локальних мінімумів. Тому корисно виконувати кілька запусків і порівнювати допустимі результати.
У опуклій задачі різні старти можуть змінити кількість ітерацій, але не повинні змінювати глобальний оптимум за коректного алгоритму.
Для опуклої задачі з єдиним мінімізатором різні розумні стартові точки повинні приводити до того самого результату в межах допуску. Якщо результати сильно відрізняються, це сигналізує про проблеми алгоритму, реалізації або критеріїв зупинки.
Для неопуклої задачі різні старти можуть законно приводити до різних локальних мінімумів. Тоді серія запусків стає частиною дослідження структури задачі.
У звіті корисно зберігати стартову точку та фінальне значення цілі для кожного запуску. Це дозволяє відрізнити стабільний алгоритм від випадкового вдалого старту.
24. Чутливість до параметрів алгоритму
Крок, допуски, максимальна кількість ітерацій та параметри пошуку довжини кроку впливають на чисельну поведінку. Тому їх треба зберігати у звіті.
Порівнювати два методи за кількістю ітерацій можна лише при однакових критеріях зупинки та з урахуванням вартості однієї ітерації.
Довжина кроку, допуски, максимальна кількість ітерацій та параметри пошуку впливають на чисельну траєкторію. Невелика зміна цих налаштувань не повинна радикально змінювати математичний результат добре поставленої опуклої задачі.
Якщо зменшення допуску суттєво змінює розв’язок, попередня точність могла бути недостатньою. Якщо результат нестабільний при невеликих змінах масштабу, варто перевірити обумовленість.
Аудит параметрів не означає перебирати все без системи. Потрібно змінювати один фактор і спостерігати, яка метрика реагує: ціль, допустимість, градієнт, кількість ітерацій або KKT-нев’язка.
Програмна реалізація та перевірка
25. Число обумовленості в NumPy
# Імпортуємо NumPy для обчислень, розв’язання моделі та її перевірки.
import numpy as np


# Задаємо матрицю кривизни у фіксованому порядку змінних.
hessian = np.array([
    [1.0, 0.0],
    [0.0, 1e6],
])

# Оцінюємо число обумовленості, щоб побачити чутливість задачі до малих числових похибок.
condition_number = np.linalg.cond(
    hessian
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print(condition_number)
Очікувано:
1000000.0
26. Перевірка скінченності
# Перевіряємо, що масив не містить NaN або нескінченностей перед математичним аудитом.
def all_finite(array):
    # np.isfinite перевіряє кожний елемент, а np.all вимагає успіху для всього масиву.
    return bool(
        np.all(
            np.isfinite(array)
        )
    )
Цю перевірку варто робити до порівняння з числовими допусками.
27. Іменовані допуски
Не варто розкидати 1e-6 по різних місцях коду без пояснення. Краще використовувати іменовані параметри:
# Обчислюємо чисельну діагностику для фінального аудиту.
FEASIBILITY_TOLERANCE = 1e-6
GRADIENT_TOLERANCE = 1e-6
KKT_TOLERANCE = 1e-6
Різні нев’язки можуть потребувати різних масштабів.
28. Універсальні метрики перевірки
# Обчислюємо максимальне порушення нерівностей у єдиній знаковій домовленості.
def max_inequality_violation(values):
    values = np.asarray(
        values,
        dtype=float,
    )

    # Повертаємо результат допоміжного обчислення у погодженому числовому форматі.
    return float(
        np.max(
            np.maximum(values, 0.0)
        )
    )


# Виносимо окрему математичну операцію в допоміжну функцію, щоб її було легко перевірити.
def vector_norm(values):
    values = np.asarray(
        values,
        dtype=float,
    )

    # Повертаємо результат допоміжного обчислення у погодженому числовому форматі.
    return float(
        np.linalg.norm(values)
    )
Функції залишають математичний зміст видимим: одна вимірює порушення нерівностей, інша — норму вектора нев’язки.
29. Панель нев’язок
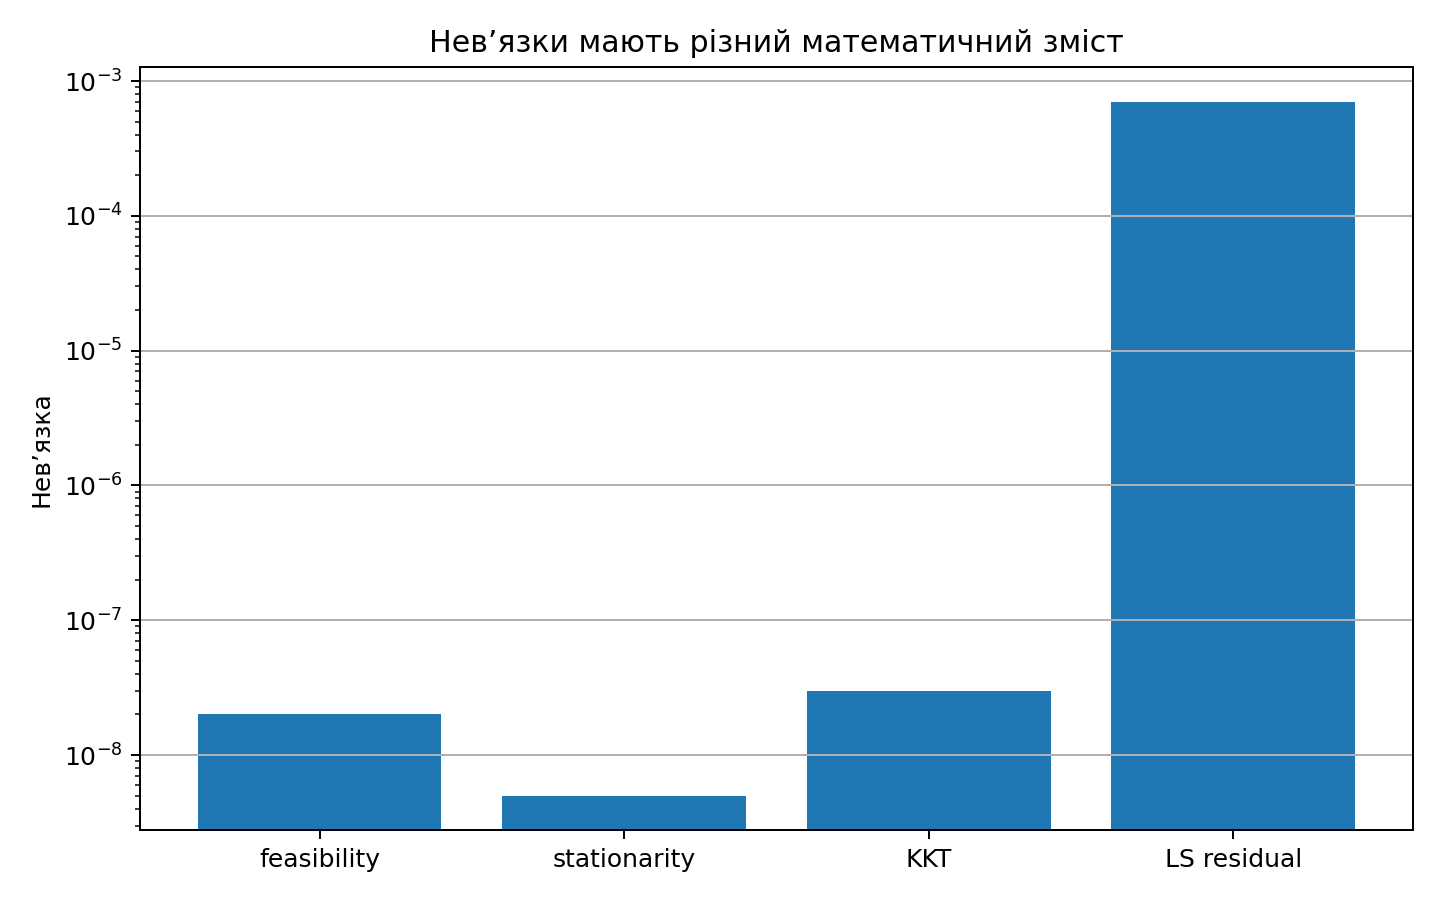
Різні нев’язки мають різний зміст і різні одиниці. Тому однакове число \(10^{-4}\) може бути прийнятним для однієї умови та надто великим для іншої.
30. Машиночитний блок результату
Для різних класів задач можна використовувати поля:
VARIANT
STATUS
X
OBJECTIVE
MAX_CONSTRAINT_VIOLATION
RESIDUAL
GRAD_NORM
DUALITY_GAP
KKT_RESIDUAL
ITERATIONS
Невикористовувані поля можна пропустити. Важливо, щоб кожне поле мало чітке математичне визначення.
Структурований блок результату дозволяє автоматично перевіряти різні класи задач. Наприклад:
STATUS: OPTIMAL
X: [...]
OBJECTIVE: ...
MAX_CONSTRAINT_VIOLATION: ...
GRAD_NORM: ...
DUALITY_GAP: ...
KKT_RESIDUAL: ...
ITERATIONS: ...
Не кожне поле потрібне для кожної задачі. У лінійному програмуванні корисний розрив двоїстості, у гладкій задачі без обмежень — норма градієнта, у задачі з нерівностями — KKT-нев’язка.
Формат повинен мати стабільні назви та одиниці вимірювання. Тоді автоматична перевірка може відрізняти математичні критерії від текстового оформлення.
31. Відтворюваність
Для повторення обчислення зберігають:
- вхідні дані;
- версію Python;
- версії бібліотек;
- назву методу;
- початкову точку;
- допуски;
- максимальну кількість ітерацій;
- параметри чисельного розв’язувача.
Для випадкових алгоритмів додають початкове значення генератора випадкових чисел.
Відтворюваний результат означає, що інша людина може повторити обчислення з тими самими даними та налаштуваннями. Для цього потрібно зберегти початкові дані, порядок змінних, версію моделі, метод, ключові параметри, допуски й точні числові результати до округлення.
Якщо алгоритм використовує випадковість, фіксують початковий стан генератора випадкових чисел. Для детермінованого методу це поле не потрібне.
Версії бібліотек важливі тоді, коли реалізаційні деталі можуть змінити траєкторію або статус. Проте математичний перевіряльник повинен залишатися стабільним: допустимість і ціль обчислюються з початкової моделі.
Відтворюваність перетворює одноразовий результат на технічний доказ, який можна перевірити пізніше.
Інтерпретація, межі та підсумок
32. Типові помилки
Типова помилка. Успішний статус чисельного розв’язувача вважають доказом правильності. Статус є лише одним джерелом інформації.
Інша помилка — округлювати координати до перевірки обмежень. Раннє округлення може змінити активний набір або створити штучне порушення.
33. Кілька оптимальних розв’язків
Якщо задача має багато оптимальних точок, автоматична перевірка не повинна вимагати точного збігу одного вектора \(x\). Треба перевірити допустимість і значення цільової функції з допуском.
Для опуклої задачі додатково можна використати нев’язку KKT.
34. Що робити при статусі «недопустима задача»
Спочатку перевіряють знаки обмежень, одиниці вимірювання, дубльовані межі й суперечливі рівності. Якщо модель сформульована правильно, недопустимість є корисним результатом: задані вимоги не можуть бути виконані одночасно.
Це не обов’язково програмний збій.
35. Що означає необмеженість
Статус необмеженості означає, що цільову функцію можна поліпшувати без скінченної межі в допустимій області. Типові причини — відсутнє ресурсне обмеження або неправильний знак.
Перед прийняттям такого висновку корисно знайти або пояснити напрям необмеженого поліпшення.
36. Перевірка лінійного програмування
Для LP корисно перевіряти:
- пряму допустимість;
- значення цілі;
- двоїсту допустимість;
- розрив двоїстості.
Малий розрив двоїстості є сильним сертифікатом за відповідних умов.
37. Перевірка гладкої задачі без обмежень
Перевіряють:
- норму градієнта;
- історію цільової функції;
- довжини кроків;
- скінченність значень;
- кривизну поблизу кандидата, якщо матриця Гессе доступна.
У опуклій функції мала норма градієнта має глобальний зміст. У неопуклій — лише підтверджує стаціонарність.
38. Перевірка задачі з обмеженнями
Перевіряють усі обмеження, набір активних обмежень, множники, градієнт функції Лагранжа та нев’язки KKT. Якщо заявляється глобальний оптимум, потрібне обґрунтування опуклості або інша достатня теорема.
39. Чисельно стійкий алгоритм не виправляє погану задачу
Навіть найкращий алгоритм не може створити інформацію, якої немає в даних. Якщо стовпці матриці майже залежні, параметри природно чутливі. Алгоритм може не додавати зайвої похибки, але число обумовленості все одно обмежує кількість надійних цифр.
Регуляризація може зменшити цю чутливість, але вона вже змінює саму оптимізаційну задачу.
Стабільний алгоритм намагається не підсилювати чисельні похибки більше, ніж це необхідно. Проте він не може усунути фундаментальну чутливість самої задачі.
Якщо дані майже лінійно залежні, розв’язок може бути нестабільним навіть при якісній реалізації. Якщо модель має неправильні одиниці або суперечливі обмеження, кращий алгоритм лише швидше розв’яже неправильну постановку.
Тому чисельна надійність має два рівні. Перший — добре поставлена й масштабована математична модель. Другий — алгоритм і реалізація, які поважають цю структуру.
У фінальному аудиті потрібно перевіряти обидва рівні окремо.
Інтерактивна самоперевірка лекції
Пройдіть 10 коротких питань. Після кожної відповіді ви побачите пояснення, а за потреби — підказку й повний розбір.
40. Підсумок
Чисельна надійність вимагає розрізняти похибку, нев’язку та обумовленість. Похибка порівнює результат із точним розв’язком, якщо він відомий, нев’язка вимірює виконання конкретної математичної умови, а число обумовленості показує чутливість задачі до малих змін даних. Мала нев’язка в погано обумовленій задачі ще не гарантує малу похибку.
Масштабування може суттєво змінити чисельну геометрію без зміни предметного змісту моделі. У наскрізному прикладі матриця Гессе \(\operatorname{diag}(1,10^6)\) має число обумовленості \(10^6\), а після заміни \(z=1000y\) воно зменшується до 1. Після розв’язання масштабованої задачі результат потрібно повернути до початкових одиниць.
Фінальний аудит збирає статус, допустимість, повторно обчислену ціль, відповідні нев’язки, допуски, кількість ітерацій і чутливість до параметрів алгоритму. Для різних класів задач використовуються різні сертифікати, тому кожне поле звіту повинно мати математичне означення. Робочий цикл усього курсу завершується послідовністю «постановка → модель → метод → обчислення → перевірка → інтерпретація».