Лекція 27. Метод найменших квадратів як оптимізаційна модель
Коротко про лекцію
Метод найменших квадратів розглядається як оптимізаційна модель для оцінювання параметрів за надлишковими даними. Ви навчитеся будувати матрицю ознак, знаходити параметри та аналізувати вектор і норму залишків.
Практичний сенс. Дані рідко лежать точно на математичній моделі. Метод найменших квадратів вибирає параметри, які роблять суму квадратів відхилень між спостереженнями й прогнозом найменшою. Це одна з найважливіших оптимізаційних моделей у статистиці, інженерії, калібруванні та аналізі даних.
Постановка та базові поняття
1. Яку проблему розв’язує метод найменших квадратів
Нехай маємо точки:
Хочемо описати їх прямою:
Жодна пряма не проходить точно через усі чотири точки. Тому треба визначити, що означає «найкраще наближення».
У реальних даних точки рідко лежать точно на одній прямій або іншій вибраній моделі. Причинами є вимірювальна похибка, невраховані фактори та спрощення самої моделі. Тому вимога «пряма повинна проходити через усі точки» зазвичай несумісна з даними.
Потрібен критерій, який вимірює загальну невідповідність. Для кожного спостереження обчислюємо залишок — різницю між прогнозом моделі та фактичним значенням. Метод найменших квадратів вибирає параметри, для яких сума квадратів цих залишків мінімальна.
Цей підхід перетворює задачу підгонки на звичайну оптимізаційну модель. Змінними рішення стають параметри моделі, дані входять у матрицю та вектор спостережень, а цільова функція вимірює якість підгонки.
1.1. Чому метод має таку назву
Для кожного спостереження модель дає прогноз \(\widehat y_i\). Різницю між прогнозом і фактичним значенням називають залишком:
Якщо просто додати залишки зі знаками, додатні та від’ємні значення можуть погасити одне одного. Тому кожний залишок підносять до квадрата. Метод вибирає параметри, для яких сума квадратів залишків найменша. Звідси й назва.
2. Навчальні дані
Запишемо:
| \(x_i\) | \(y_i\) |
|---|---|
| 0 | 1 |
| 1 | 2 |
| 2 | 2 |
| 3 | 4 |
Модель має два параметри: кутовий коефіцієнт \(a\) і вільний член \(b\).
3. Один залишок вручну
Для точки \((2,2)\) прогноз:
Залишок:
Так кожний рядок даних створює один залишок.
4. Чому використовують квадрат
Квадрат має три корисні властивості. Він невід’ємний, тому знаки не компенсують одне одного. Він сильніше штрафує великі відхилення. Він дає гладку диференційовну цільову функцію.
Водночас сильний квадратний штраф робить метод чутливим до викидів. Це важливе обмеження, яке треба пам’ятати під час інтерпретації.
Квадрат залишку виконує кілька функцій одночасно. Він робить внесок невід’ємним, тому позитивні й негативні відхилення не компенсують одне одного. Великий залишок отримує сильніший штраф, бо його внесок росте квадратично. Крім того, квадрат є гладкою функцією, що спрощує похідні та приводить до лінійної системи для лінійної моделі.
Наприклад, два залишки \(-2\) і \(2\) мають суму нуль, хоча модель помиляється в обох точках. Сума квадратів дорівнює \(4+4=8\) і правильно показує наявність відхилення.
Водночас квадратичний штраф робить метод чутливим до великих викидів. Одна дуже нетипова точка може суттєво вплинути на параметри. Тому після розв’язання важливо аналізувати самі залишки, а не тільки їхню суму.
5. Цільова функція
Сума квадратів залишків:
Для наших даних:
Мета — знайти \(a\) та \(b\), які мінімізують \(S\).
Математична логіка
6. Матрична форма
Параметри зберемо у вектор:
Матриця ознак:
Вектор спостережень:
Прогнози:
Для лінійної за параметрами моделі всі прогнози можна записати одним матричним добутком:
Матриця \(A\) називається матрицею ознак або матрицею дизайну. Кожний рядок відповідає одному спостереженню, а кожний стовпець — одному параметру.
Для прямої \(\widehat y=ax+b\) зручно взяти:
а рядок для аргументу \(x_i\) має вигляд \((x_i,1)\). Остання одиниця відповідає вільному члену.
Порядок стовпців критично важливий. Якщо в \(\theta\) спочатку записати \(b\), а потім \(a\), матриця \(A\) також повинна змінитися. Програма може виконати множення без помилки типів, але математично розв’яже іншу модель.
7. Вектор залишків
За нашою знаковою домовленістю:
Тоді ціль:
Цей запис стискає чотири залишки в одну векторну формулу.
8. Звідки беруться нормальні рівняння
Розкриємо квадрат норми:
Градієнт:
У стаціонарній точці:
Отже:
Цю систему називають нормальними рівняннями.
Цільова функція:
може бути розкрита як:
Її градієнт:
У стаціонарній точці:
звідси:
Це і є нормальні рівняння. Вони не є окремим «трюком». Вони безпосередньо виникають з умови нульового градієнта для квадратичної цілі.
Якщо \(A\) має повний стовпчиковий ранг, матриця \(A^TA\) додатно визначена, тому стаціонарна точка є єдиним глобальним мінімізатором.
9. Чому слово «нормальні» пов’язане з геометрією
У оптимумі:
Це означає, що вектор залишків ортогональний кожному стовпцю \(A\). Геометрично прогноз \(A\theta\) є ортогональною проєкцією \(y\) на простір, натягнутий на стовпці \(A\).
Тому «нормальні рівняння» відображають перпендикулярність залишку до модельного підпростору.
У мінімізаторі залишок:
задовольняє:
Це означає, що \(r\) ортогональний до кожного стовпця \(A\). Вектор прогнозів \(A\theta^*\) є ортогональною проєкцією вектора \(y\) на простір стовпців матриці \(A\).
Геометрично дані \(y\) розкладаються на дві частини: компоненту, яку може описати модель, і залишок, перпендикулярний до всіх дозволених напрямів зміни прогнозу.
Слово «нормальний» пов’язане саме з цією перпендикулярністю. Тому рівняння \(A^Tr=0\) корисно перевіряти незалежно від способу чисельного розв’язання.
10. Обчислюємо AᵀA
Права частина:
Отже:
11. Розв’язуємо систему
Маємо:
Розв’язок:
Тому пряма:
12. Перевіряємо прогнози
Для \(x=0,1,2,3\):
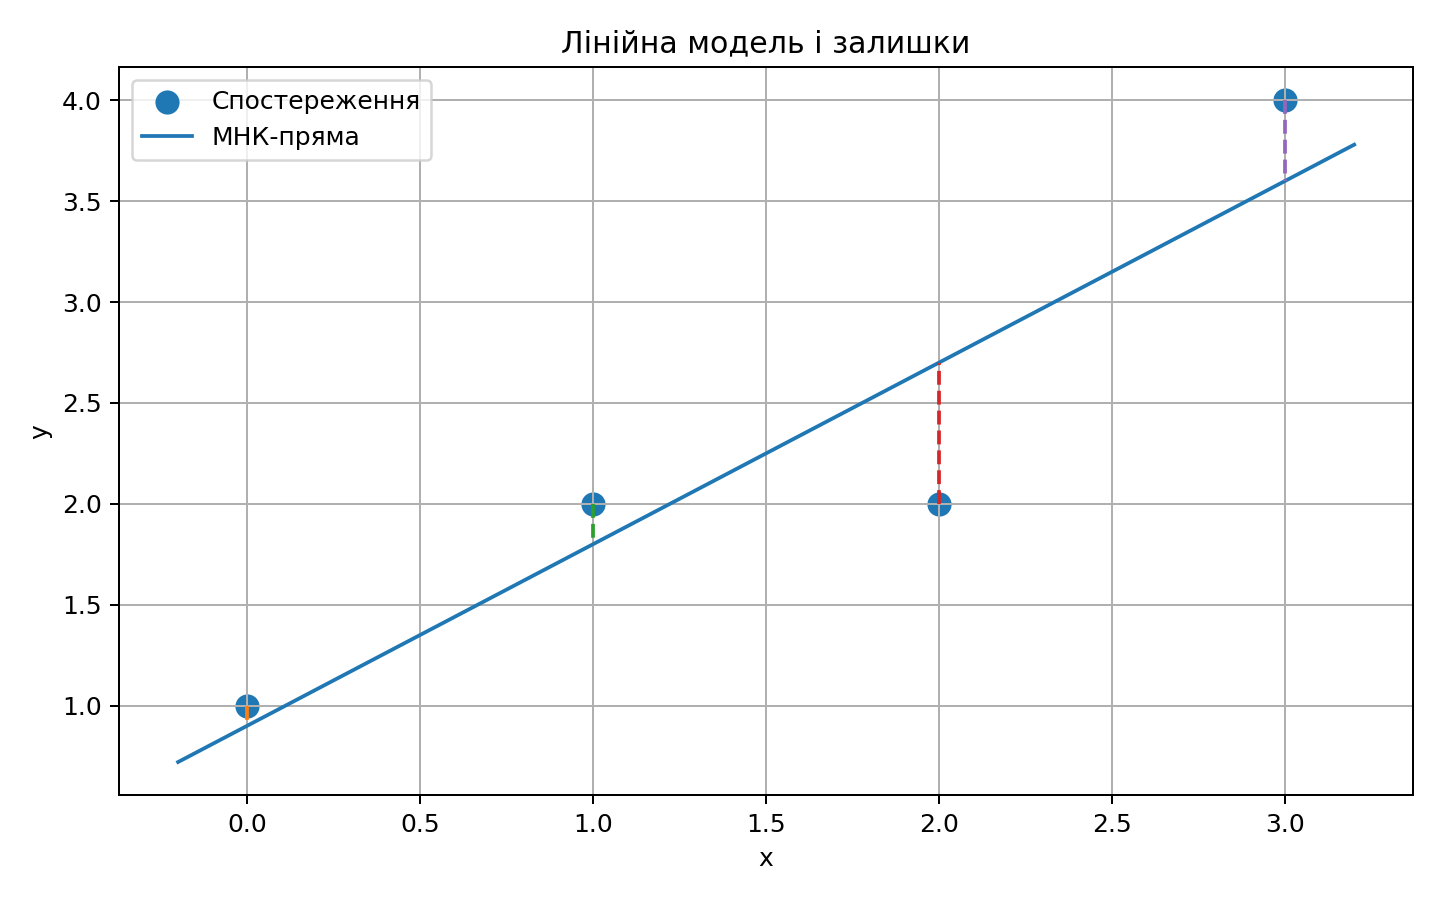
13. Обчислюємо залишки
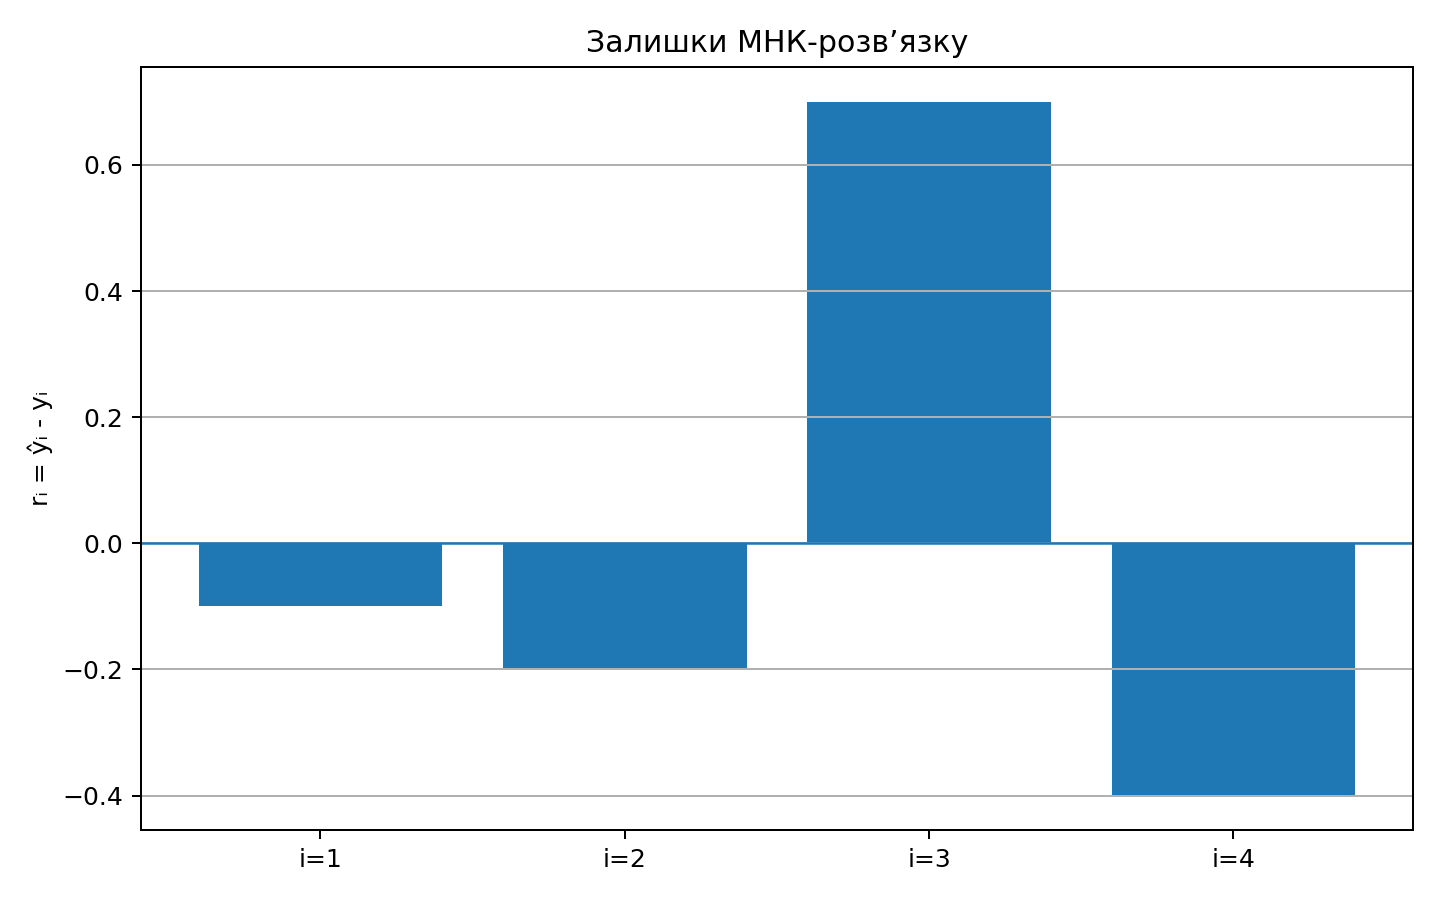
За формулою \(r=\widehat y-y\):
Сума квадратів:
Скорочення SSE означає суму квадратів похибок. Його часто використовують у статистичних пакетах, тому варто вміти впізнавати.
14. Перевірка ортогональності
Обчислюємо:
Для точного розв’язку воно дорівнює нулю. Через округлення очікуємо дуже малий вектор.
Це сильніша перевірка, ніж просто повторне обчислення SSE, бо вона безпосередньо підтверджує умову стаціонарності.
15. Ранг матриці
Щоб параметри визначались однозначно, стовпці \(A\) повинні бути лінійно незалежними. Для нашої матриці ранг дорівнює 2, тобто максимальному можливому значенню для двох стовпців.
Якщо ранг менший, деякі параметри неможливо визначити окремо з наявних даних. Це називають дефіцитом рангу.
Повний стовпчиковий ранг означає, що жоден параметр не можна виразити через інші стовпці матриці \(A\). Тоді дані містять достатньо незалежної інформації, щоб однозначно визначити параметри за критерієм найменших квадратів.
Якщо два стовпці однакові або один є кратним іншому, різні вектори параметрів можуть давати однакові прогнози. Цільова функція матиме плоский напрям, а мінімізатор параметрів стане неєдиним.
У прикладній роботі дефіцит рангу часто виникає через дубльовані ознаки, надмірну кількість параметрів або помилкове кодування даних. Тому ранг — це характеристика моделі й даних, а не тільки технічна властивість матриці.
16. Приклад дефіциту рангу
Нехай два стовпці матриці є однаковими. Тоді зміна одного параметра може бути компенсована протилежною зміною другого без зміни прогнозу. Отже, існує багато векторів параметрів з однаковою сумою квадратів.
У такій ситуації бібліотека може повернути один з мінімально-нормових розв’язків, але параметри вже не мають однозначної інтерпретації.
Алгоритм і покроковий розбір
17. Повний алгоритм моделювання
- вибрати форму прогнозної моделі;
- сформувати матрицю ознак \(A\);
- сформувати вектор спостережень \(y\);
- перевірити розмірності;
- оцінити ранг;
- знайти параметри;
- обчислити прогнози;
- обчислити залишки;
- обчислити SSE;
- перевірити \(A^Tr\).
18. Чому не варто явно обертати AᵀA
Формально можна написати:
Проте явне обернення матриці в коді зайве. Для маленької ручної задачі формула корисна теоретично, а в програмі краще використовувати спеціалізовані алгоритми.
Формула:
корисна для теоретичного виведення, але її не варто буквально реалізовувати через обернення матриці. Чисельне розв’язання системи стабільніше й дешевше.
Крім того, формування \(A^TA\) погіршує обумовленість: у спектральному сенсі число обумовленості приблизно підноситься до квадрата. Якщо \(A\) уже має проблемні масштаби, нормальні рівняння можуть втратити значущі цифри.
Тому np.linalg.lstsq використовує надійніші алгоритми лінійної алгебри. Для навчання нормальні рівняння залишаються важливими, бо пояснюють стаціонарність і ортогональність. Для обчислення краще використовувати спеціалізований розв’язувач.
19. Чому нормальні рівняння можуть бути чисельно слабшими
Число обумовленості матриці \(A^TA\) приблизно дорівнює квадрату числа обумовленості \(A\) за стандартних умов. Тому майже залежні стовпці стають ще проблемнішими.
У чисельній практиці часто використовують QR-розклад або сингулярний розклад, які не потребують явного формування \(A^TA\).
20. SSE та RMSE
SSE залежить від кількості спостережень. Для більш інтуїтивного масштабу часто використовують середньоквадратичну помилку:
де \(m\) — кількість спостережень.
Для нашого прикладу:
RMSE має ті самі одиниці, що й \(y\).
SSE — усталене скорочення для суми квадратів залишків:
Вона має одиниці вимірювання, піднесені до квадрату. Через це її не завжди зручно інтерпретувати предметно.
RMSE — корінь із середнього квадрата залишків — повертає масштаб початкової величини:
Для наших чотирьох точок SSE дорівнює \(0.70\), тому:
RMSE дозволяє сказати, що типовий масштаб помилки прогнозу становить приблизно 0.42 одиниці \(y\). Порівнювати RMSE між різними наборами даних потрібно з урахуванням масштабу та предметного змісту.
21. Знак залишку
Ми визначили:
Деякі джерела використовують протилежний знак \(y-\widehat y\). SSE від цього не змінюється, бо залишки підносяться до квадрата. Проте вектор \(A^Tr\) змінює знак.
Тому знакову домовленість треба зафіксувати один раз і використовувати послідовно.
22. Викиди
Квадрат великих залишків швидко зростає. Через це одна дуже нетипова точка може суттєво змістити пряму найменших квадратів.
Це властивість квадратичної функції втрат. Якщо викиди є суттєвою частиною задачі, можуть знадобитися робастніші функції втрат.
Через квадрат великий залишок отримує непропорційно великий вплив. Якщо один залишок дорівнює 10, його внесок у SSE становить 100. Десять залишків величини 1 разом дають лише 10.
Тому після підгонки потрібно дивитися на графік залишків та окремі великі відхилення. Викид може означати помилку даних, особливий режим процесу або недостатню форму моделі. Автоматичне видалення точки без предметного обґрунтування небезпечне.
Для даних із частими великими викидами існують робастні критерії, наприклад абсолютні відхилення або функція Губера. Вони виходять за основну тему цієї лекції, але показують, що найменші квадрати є конкретним вибором моделі похибки.
Програмна реалізація та перевірка
23. Розв’язання через NumPy
# Імпортуємо NumPy для обчислень, розв’язання моделі та її перевірки.
import numpy as np


# Задаємо матрицю коефіцієнтів; порядок рядків і стовпців має збігатися з математичною моделлю.
A = np.array([
    [0.0, 1.0],
    [1.0, 1.0],
    [2.0, 1.0],
    [3.0, 1.0],
])

# Задаємо праві частини, запаси або спостереження у порядку, узгодженому з рядками матриці.
y = np.array([
    1.0,
    2.0,
    2.0,
    4.0,
])

# Знаходимо параметри найменших квадратів через lstsq; разом із параметрами зберігаємо ранг для діагностики.
parameters, _, rank, singular_values = np.linalg.lstsq(
    A,
    y,
    rcond=None,
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print("PARAMETERS:", parameters)
print("RANK:", rank)
print("SINGULAR_VALUES:", singular_values)
Очікувані параметри близькі до \((0.9,0.9)\).
Навчальна реалізація може починатися з явної матриці \(A\) та вектора \(y\):
# Задаємо матрицю коефіцієнтів; порядок рядків і стовпців має збігатися з математичною моделлю.
A = np.array([
    [0.0, 1.0],
    [1.0, 1.0],
    [2.0, 1.0],
    [3.0, 1.0],
])
y = np.array([1.0, 2.0, 2.0, 4.0])

# Знаходимо параметри найменших квадратів через lstsq; разом із параметрами зберігаємо ранг для діагностики.
theta, *_ = np.linalg.lstsq(
    A,
    y,
    rcond=None,
)
Очікуємо \(\theta\approx(0.9,0.9)^T\). Після цього обчислюємо прогноз, залишки та SSE власними формулами.
Використання *_ у навчальному коді доречне лише після пояснення, що функція повертає додаткові діагностичні значення. У повному звіті краще зберегти ранг і сингулярні значення окремими змінними.
24. Незалежне обчислення залишків
# Перевіряємо ортогональність залишку до стовпців матриці ознак — умову розв’язку найменших квадратів.
predictions = A @ parameters
residuals = predictions - y
sse = residuals @ residuals
normal_residual = np.linalg.norm(
    A.T @ residuals
)

# Виводимо результат і діагностичні величини, щоб зіставити їх з очікуваними числами.
print("PREDICTIONS:", predictions)
print("RESIDUALS:", residuals)
print("SSE:", sse)
print("NORMAL_RESIDUAL:", normal_residual)
Очікувано SSE близька до 0.70, а нев’язка нормальних рівнянь — до машинного нуля.
25. Що повертає np.linalg.lstsq
Функція повертає параметри, додаткову інформацію про залишки, оцінку рангу та сингулярні значення. Конкретна форма додаткових полів залежить від розміру та рангу матриці, тому SSE корисно обчислювати незалежно з вихідної формули.
Функція np.linalg.lstsq повертає кілька об’єктів: оцінку параметрів, суму квадратів залишків для відповідного випадку, ранг матриці та сингулярні значення. Ці додаткові поля потрібні для діагностики.
Ранг показує, чи достатньо незалежних стовпців. Сингулярні значення допомагають оцінити масштаб і обумовленість. Дуже мале сингулярне значення порівняно з найбільшим сигналізує про майже лінійну залежність ознак.
Після отримання параметрів все одно варто самостійно обчислити predictions = A @ theta, residuals = predictions - y, SSE та \(A^Tr\). Так код перевірки залишається зрозумілим і не залежить від трактування одного поля бібліотеки.
26. Функція найменших квадратів у SciPy
Для нелінійної моделі залишків зручно використовувати scipy.optimize.least_squares. Тоді користувач задає функцію, яка повертає вектор залишків, а бібліотека мінімізує суму їхніх квадратів.
Це вже розширення тієї самої ідеї на моделі, де прогноз нелінійно залежить від параметрів.
scipy.optimize.least_squares потрібна, коли залишки залежать від параметрів нелінійно. Користувач передає функцію, яка повертає вектор залишків, а бібліотека мінімізує їхню суму квадратів.
Для лінійної моделі ця функція надмірна, бо np.linalg.lstsq використовує структуру задачі ефективніше. Проте порівняння двох підходів показує спільну ідею: критерієм служить норма вектора залишків.
Після нелінійного розв’язання перевіряються самі залишки, норма градієнтного аналога та статус алгоритму. Назва функції не змінює математичний критерій.
27. Мінімальний блок результату
PARAMETERS
SSE
RMSE
RANK
NORMAL_RESIDUAL
Для чисельно підозрілої задачі варто додати сингулярні значення та число обумовленості матриці ознак.
Для лінійних найменших квадратів корисний блок:
PARAMETERS: [0.9, 0.9]
PREDICTIONS: [0.9, 1.8, 2.7, 3.6]
RESIDUALS: [-0.1, -0.2, 0.7, -0.4]
SSE: 0.70
RMSE: 0.4183
RANK: 2
NORMAL_EQUATION_RESIDUAL: near 0
Параметри без залишків дають неповну картину. Вектор залишків показує, де модель помиляється і в який бік. SSE агрегує загальну квадратичну похибку. RMSE повертає масштаб початкової змінної. Ранг перевіряє ідентифікованість параметрів.
Нев’язку нормальних рівнянь можна обчислити як:
Вона повинна бути малою для правильного розв’язку.
Якщо np.linalg.lstsq повертає малу SSE, але ранг менший за кількість параметрів, потрібно прямо вказати неєдиність або слабку визначеність коефіцієнтів. Число підгонки не скасовує структурної проблеми.
Такий блок легко розширити у регуляризованій задачі: додаються \(\lambda\), норма параметрів і регуляризована стаціонарна нев’язка.
Інтерпретація, межі та підсумок
28. Типові помилки
Типова помилка. Метод оцінюють лише за SSE. Мала SSE не гарантує, що параметри добре визначені, якщо матриця ознак має майже залежні стовпці.
Інша помилка — явно обертати \(A^TA\). Також небезпечно змішувати дві домовленості про знак залишку в одному звіті.
29. Одиниці вимірювання
Якщо \(x\) вимірюється в годинах, а \(y\) — у гривнях, параметр \(a\) має одиниці «гривні на годину», а \(b\) — гривні. Залишки та RMSE мають одиниці \(y\), а SSE — квадрат цих одиниць.
Перевірка одиниць допомагає виявляти помилки у формуванні матриці ознак.
Якщо \(y\) вимірюється в метрах, залишки також мають одиниці метрів. SSE має одиниці квадратних метрів, а RMSE знову повертається до метрів.
Коефіцієнт нахилу \(a\) має одиниці «одиниці \(y\) на одиницю \(x\)». Вільний член \(b\) має ті самі одиниці, що й \(y\).
Ці одиниці корисні для перевірки формули. Якщо після побудови моделі нахил отримав одиниці, які предметно не мають сенсу, варто перевірити порядок стовпців або масштабування.
Числова оптимізація не скасовує розмірнісний аналіз. Навпаки, одиниці часто ловлять помилку раніше за тестування коду.
Розмірнісний аналіз корисний і для RMSE. Якщо RMSE дорівнює 0.42 метра, це можна порівняти з допустимою похибкою процесу. Значення 0.42 без одиниць не дає предметного висновку.
Тому числову метрику слід завершувати інтерпретацією: чи є такий рівень помилки прийнятним для задачі. Математично найкраща пряма може залишатися практично непридатною, якщо вимоги до точності значно суворіші.
30. Зв’язок з регуляризацією
При поганій обумовленості параметри можуть сильно змінюватися від малого шуму. Наступна лекція додасть до цілі штраф за великі параметри. Це змінить саму оптимізаційну задачу, але може суттєво покращити стабільність оцінювання.
Якщо матриця \(A\) має майже залежні стовпці, невеликі зміни даних можуть сильно змінювати оцінені параметри. Прогнози при цьому іноді змінюються мало, тому проблема легко залишається непоміченою.
Регуляризація додає до цілі штраф за розмір параметрів. Для квадратичного штрафу система стає:
Додавання \(\lambda I\) піднімає малі власні значення системної матриці й робить розв’язання стабільнішим. Ціна цього покращення — зміщення оцінки.
Наступна лекція розгляне цей компроміс окремо. Найменші квадрати дадуть базову модель, а регуляризація покаже, як свідомо змінити її заради кращої чисельної та статистичної стабільності.
Інтерактивна самоперевірка лекції
Пройдіть 10 коротких питань. Після кожної відповіді ви побачите пояснення, а за потреби — підказку й повний розбір.
31. Підсумок
Метод найменших квадратів формулює оцінювання параметрів як оптимізацію. Для лінійної моделі вектор прогнозів дорівнює \(A\theta\), залишок задається як \(r=A\theta-y\), а ціль має вигляд \(\|r\|_2^2\). Порядок стовпців матриці \(A\) визначає зміст компонентів \(\theta\), тому структура даних є частиною математичної моделі.
У навчальному прикладі отримано параметри \(a=0.9\) і \(b=0.9\), залишки \((-0.1,-0.2,0.7,-0.4)^T\) та \(SSE=0.70\). Нормальні рівняння \(A^Tr=0\) мають геометричний зміст: залишок ортогональний простору стовпців \(A\). Ця умова є сильною незалежною перевіркою поряд із повторним обчисленням прогнозів і суми квадратів.
Ранг і сингулярні значення показують, наскільки параметри визначені даними. Мала похибка підгонки за недостатнього рангу може співіснувати з неєдиними або нестабільними коефіцієнтами, тому чисельний звіт повинен містити SSE разом із рангом, нев’язкою та оцінкою обумовленості. Для практичного обчислення доцільно використовувати np.linalg.lstsq, яке уникає явного формування оберненої матриці та краще поводиться чисельно.
Після розв’язання корисно аналізувати форму залишків, ранг, обумовленість і предметний зміст параметрів. Систематичний рисунок залишків може вказати на невідповідність самої форми моделі, навіть якщо оптимізаційна задача розв’язана правильно. Наступна лекція покаже, як регуляризація контрольовано змінює ціль, коли параметри стають надто чутливими до даних. Перевірка стає повнішою, відтворюваною та зрозумілою.
Для повного підсумку важливо розділяти якість оптимізаційного розв’язку та якість самої моделі. np.linalg.lstsq може дуже точно знайти мінімум заданої квадратичної цілі, але цей факт ще не пояснює, чи лінійна залежність добре описує предметний процес. Тому після математичної перевірки корисно подивитися на графік залишків, їхні знаки та розподіл за спостереженнями. Систематична структура залишків може вказувати на невдалу форму моделі, а різка зміна параметрів після малого збурення даних — на проблеми рангу, масштабу або обумовленості. Такий аудит зберігає логічний зв’язок між оптимізацією, лінійною алгеброю та предметною інтерпретацією результату й робить висновок придатним для подальшого порівняння моделей.